Представление знаний и экспертные системы
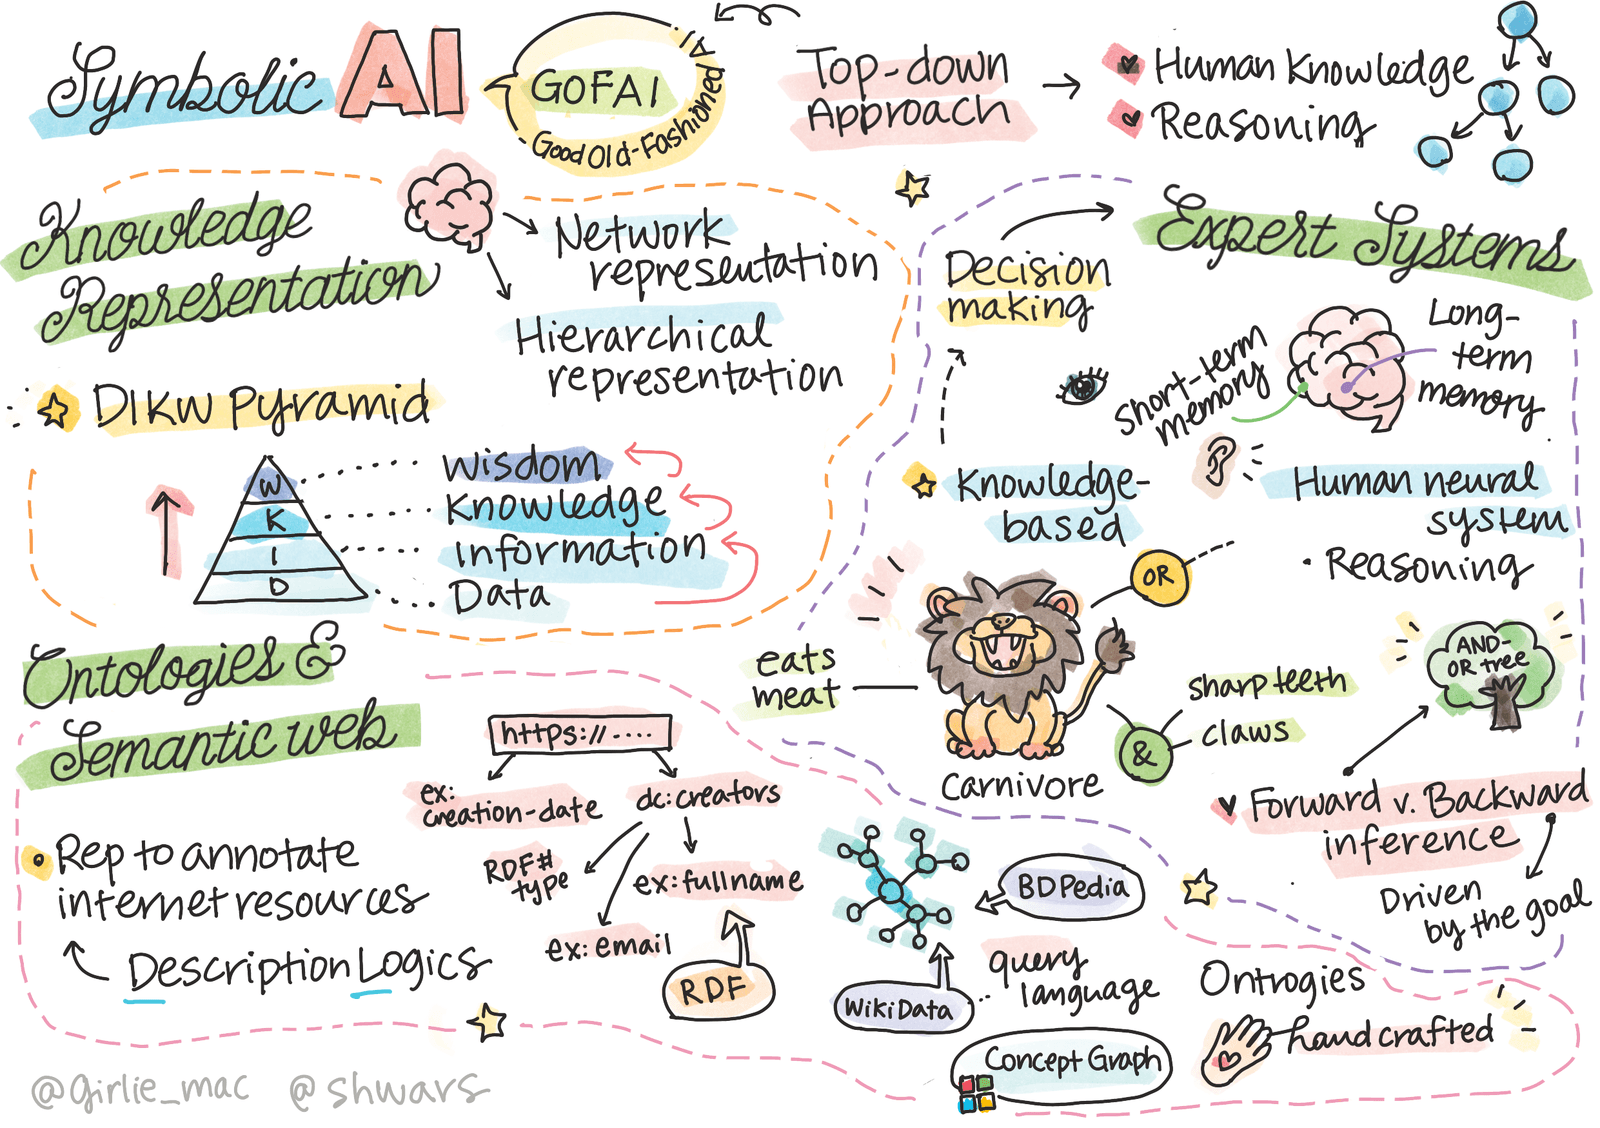
Скетчноут Томоми Имуры
Стремление к созданию искусственного интеллекта основано на поиске знаний, чтобы осмыслить мир так же, как это делают люди. Но как этого добиться?
Тест перед лекцией
На заре развития ИИ был популярен подход «сверху вниз» к созданию интеллектуальных систем (обсуждавшийся в предыдущем уроке). Идея заключалась в извлечении знаний от людей, преобразовании их в машиночитаемую форму, а затем использовании для автоматического решения задач. Этот подход основывался на двух больших идеях:
- Представление знаний
- Рассуждение
Представление знаний
Одно из важных понятий в символическом ИИ: знание. Важно отличать знание от информации или данных. Например, можно сказать, что книги содержат знания, потому что, изучая книги, можно стать экспертом. Однако то, что содержат книги, на самом деле называется данными, и, читая книги и интегрируя эти данные в нашу модель мира, мы преобразуем их в знания.
✅ Знание: это то, что содержится в нашей голове и представляет наше понимание мира. Оно получается в процессе активного обучения, которое интегрирует фрагменты информации, получаемой нами, в нашу активную модель мира.
Чаще всего мы не даём строгого определения знанию, но соотносим его с другими связанными понятиями, используя пирамиду DIKW. Она включает в себя следующие концепции:
- Данные: нечто, представленное в физической среде, например, в виде письменного текста или устных слов. Данные существуют независимо от людей и могут передаваться между ними.
- Информация: то, как мы интерпретируем данные в своей голове. Например, когда мы слышим слово компьютер, у нас есть некоторое понимание того, что это такое.
- Знание: информация, интегрированная в нашу модель мира. Например, когда мы узнаём, что такое компьютер, у нас появляются идеи о том, как он работает, сколько стоит и для чего его можно использовать. Эта сеть взаимосвязанных концепций формирует наше знание.
- Мудрость: ещё один уровень нашего понимания мира, который представляет метазнание, например, представление о том, как и когда знание должно использоваться.
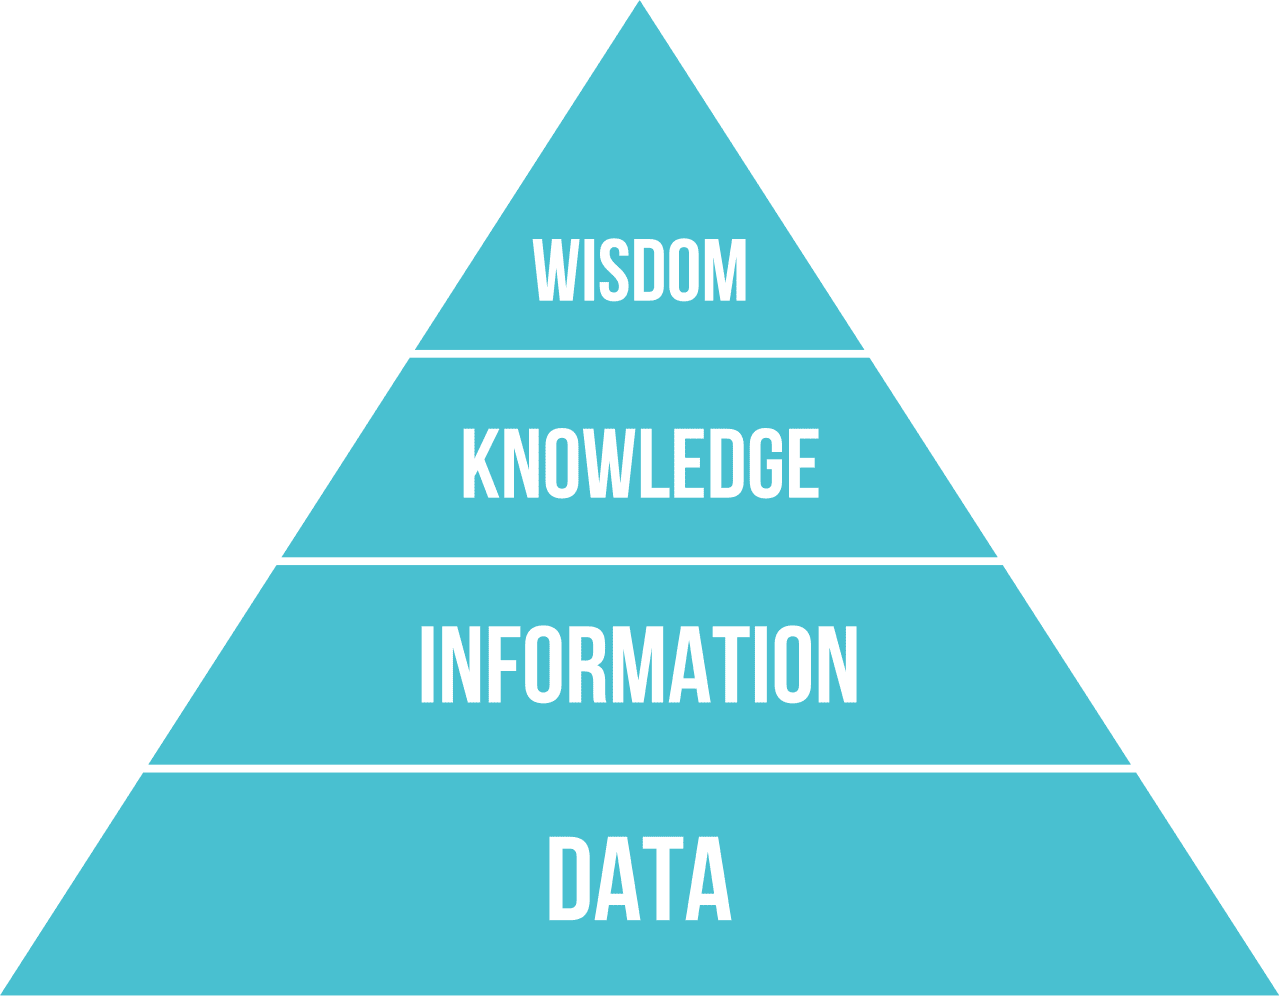
Изображение из Википедии, автор Longlivetheux, собственная работа, CC BY-SA 4.0
Таким образом, задача представления знаний состоит в том, чтобы найти эффективный способ представления знаний внутри компьютера в виде данных, чтобы они могли использоваться автоматически. Это можно рассматривать как спектр:
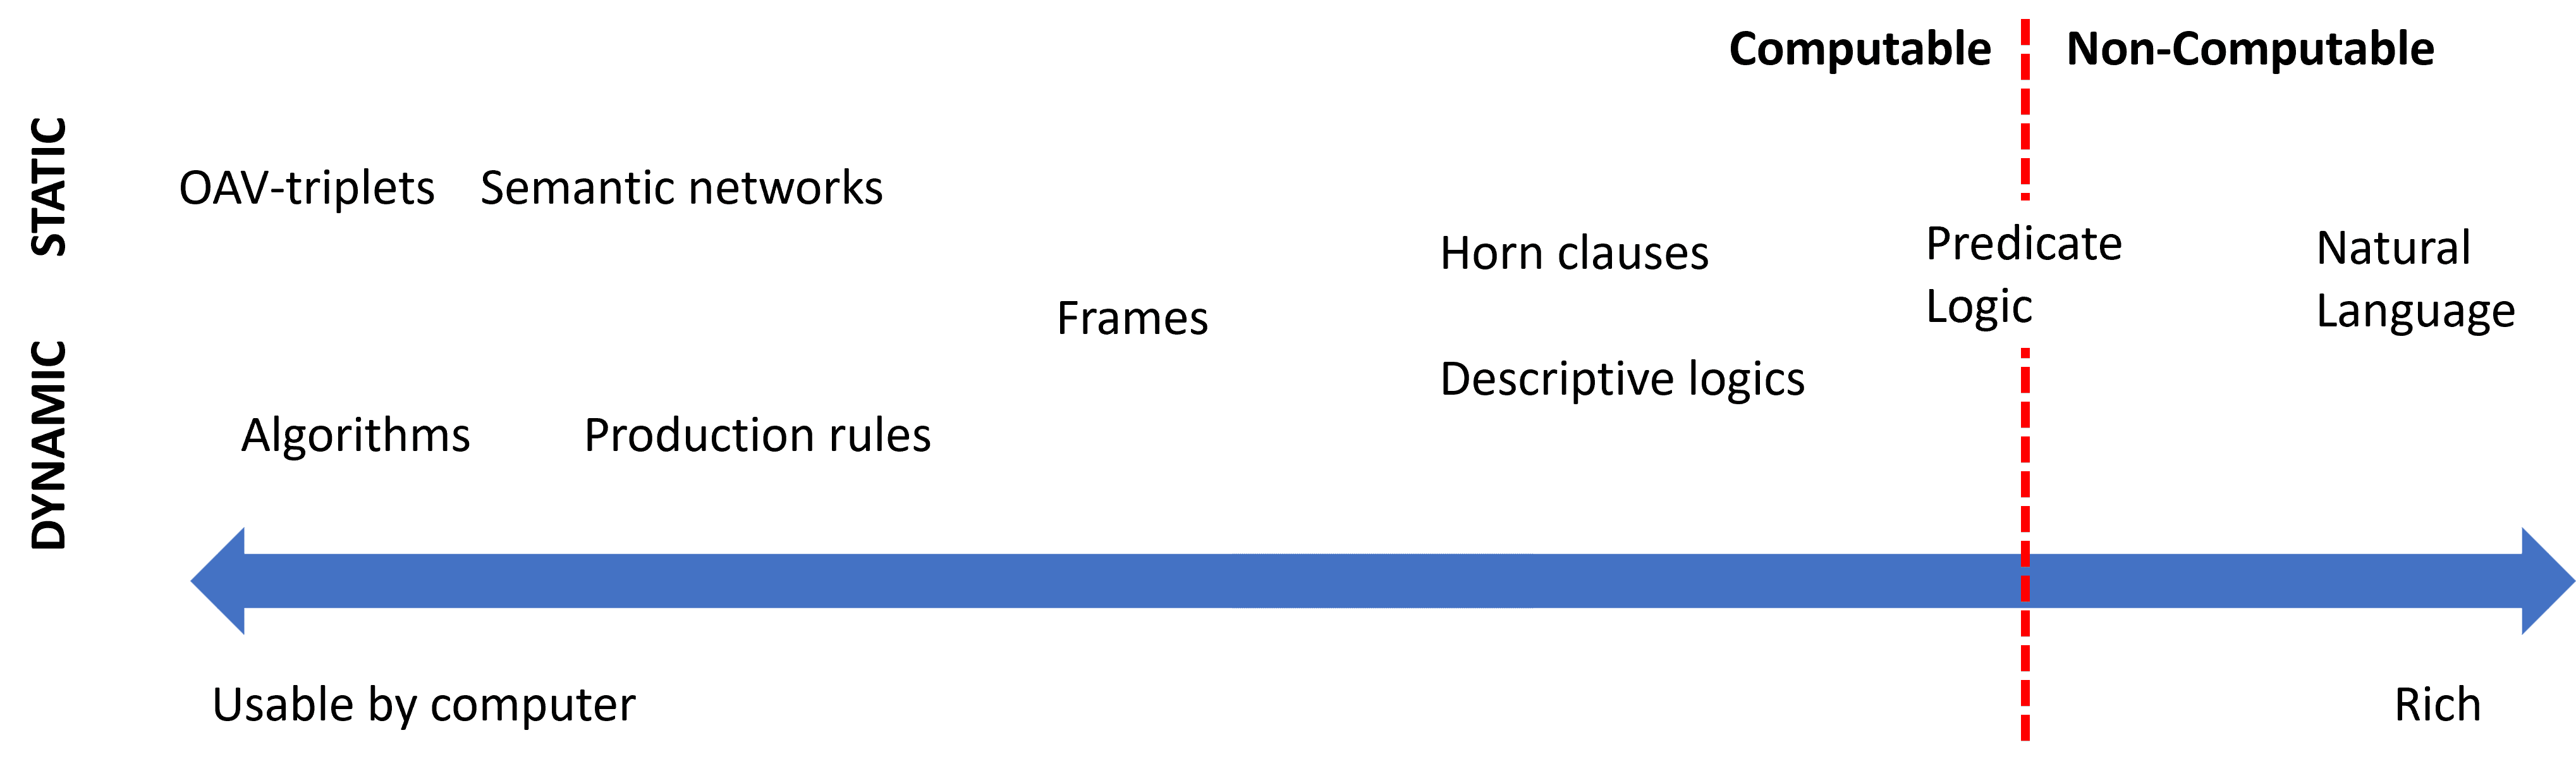
Изображение Дмитрия Сошникова
- Слева представлены очень простые типы представления знаний, которые могут быть эффективно использованы компьютерами. Самый простой: алгоритмический, когда знание представлено компьютерной программой. Однако это не лучший способ представления знаний, поскольку он негибок. Знания в нашей голове часто неалгоритмичны.
- Справа представлены такие способы, как естественный текст. Это самый мощный способ, но он не может быть использован для автоматического рассуждения.
✅ Подумайте минуту, как вы представляете знания в своей голове и как преобразуете их в заметки. Есть ли какой-то формат, который помогает вам лучше запоминать?
Классификация компьютерных представлений знаний
Мы можем классифицировать различные методы компьютерного представления знаний по следующим категориям:
- Сетевые представления основаны на том, что у нас в голове есть сеть взаимосвязанных понятий. Мы можем попытаться воспроизвести такие же сети в виде графа внутри компьютера, так называемой семантической сети.
Тройки «объект-атрибут-значение» или пары «атрибут-значение». Поскольку граф может быть представлен внутри компьютера как список узлов и рёбер, мы можем представить семантическую сеть списком троек, содержащих объекты, атрибуты и значения. Например, мы строим следующие тройки о языках программирования:
Object Attribute Value Python is Untyped-Language Python invented-by Guido van Rossum Python block-syntax indentation Untyped-Language doesn't have type definitions ✅ Подумайте, как тройки можно использовать для представления других типов знаний.
Иерархические представления подчёркивают тот факт, что мы часто создаём иерархию объектов в своей голове. Например, мы знаем, что канарейка: это птица, и у всех птиц есть крылья. У нас также есть представление о том, какого цвета обычно канарейка и какова её скорость полёта.
- Фреймовое представление основано на представлении каждого объекта или класса объектов как фрейма, который содержит слоты. Слоты имеют возможные значения по умолчанию, ограничения значений или хранимые процедуры, которые могут быть вызваны для получения значения слота. Все фреймы образуют иерархию, аналогичную иерархии объектов в объектно-ориентированных языках программирования.
- Сценарии: это особый вид фреймов, которые представляют сложные ситуации, разворачивающиеся во времени.
Python
Slot Value Default value Interval Name Python Is-A Untyped-Language Variable Case CamelCase Program Length 5-5000 lines Block Syntax Indent Процедурные представления основаны на представлении знаний списком действий, которые могут быть выполнены при наступлении определённого условия.
- Продукционные правила: это операторы «если-то», которые позволяют делать выводы. Например, у врача может быть правило, гласящее: ЕСЛИ у пациента высокая температура ИЛИ высокий уровень С-реактивного белка в анализе крови, ТО у него воспаление. При наступлении одного из условий мы можем сделать вывод о воспалении, а затем использовать его в дальнейших рассуждениях.
- Алгоритмы можно считать ещё одной формой процедурного представления, хотя они почти никогда не используются напрямую в системах, основанных на знаниях.
Логика изначально была предложена Аристотелем как способ представления универсальных человеческих знаний.
- Предикатная логика как математическая теория слишком обширна для вычислений, поэтому обычно используется её подмножество, например, хорновские дизъюнкты, применяемые в Prolog.
- Дескриптивная логика: это семейство логических систем, используемых для представления и рассуждения об иерархиях объектов и распределённых представлениях знаний, таких как семантическая паутина.
Экспертные системы
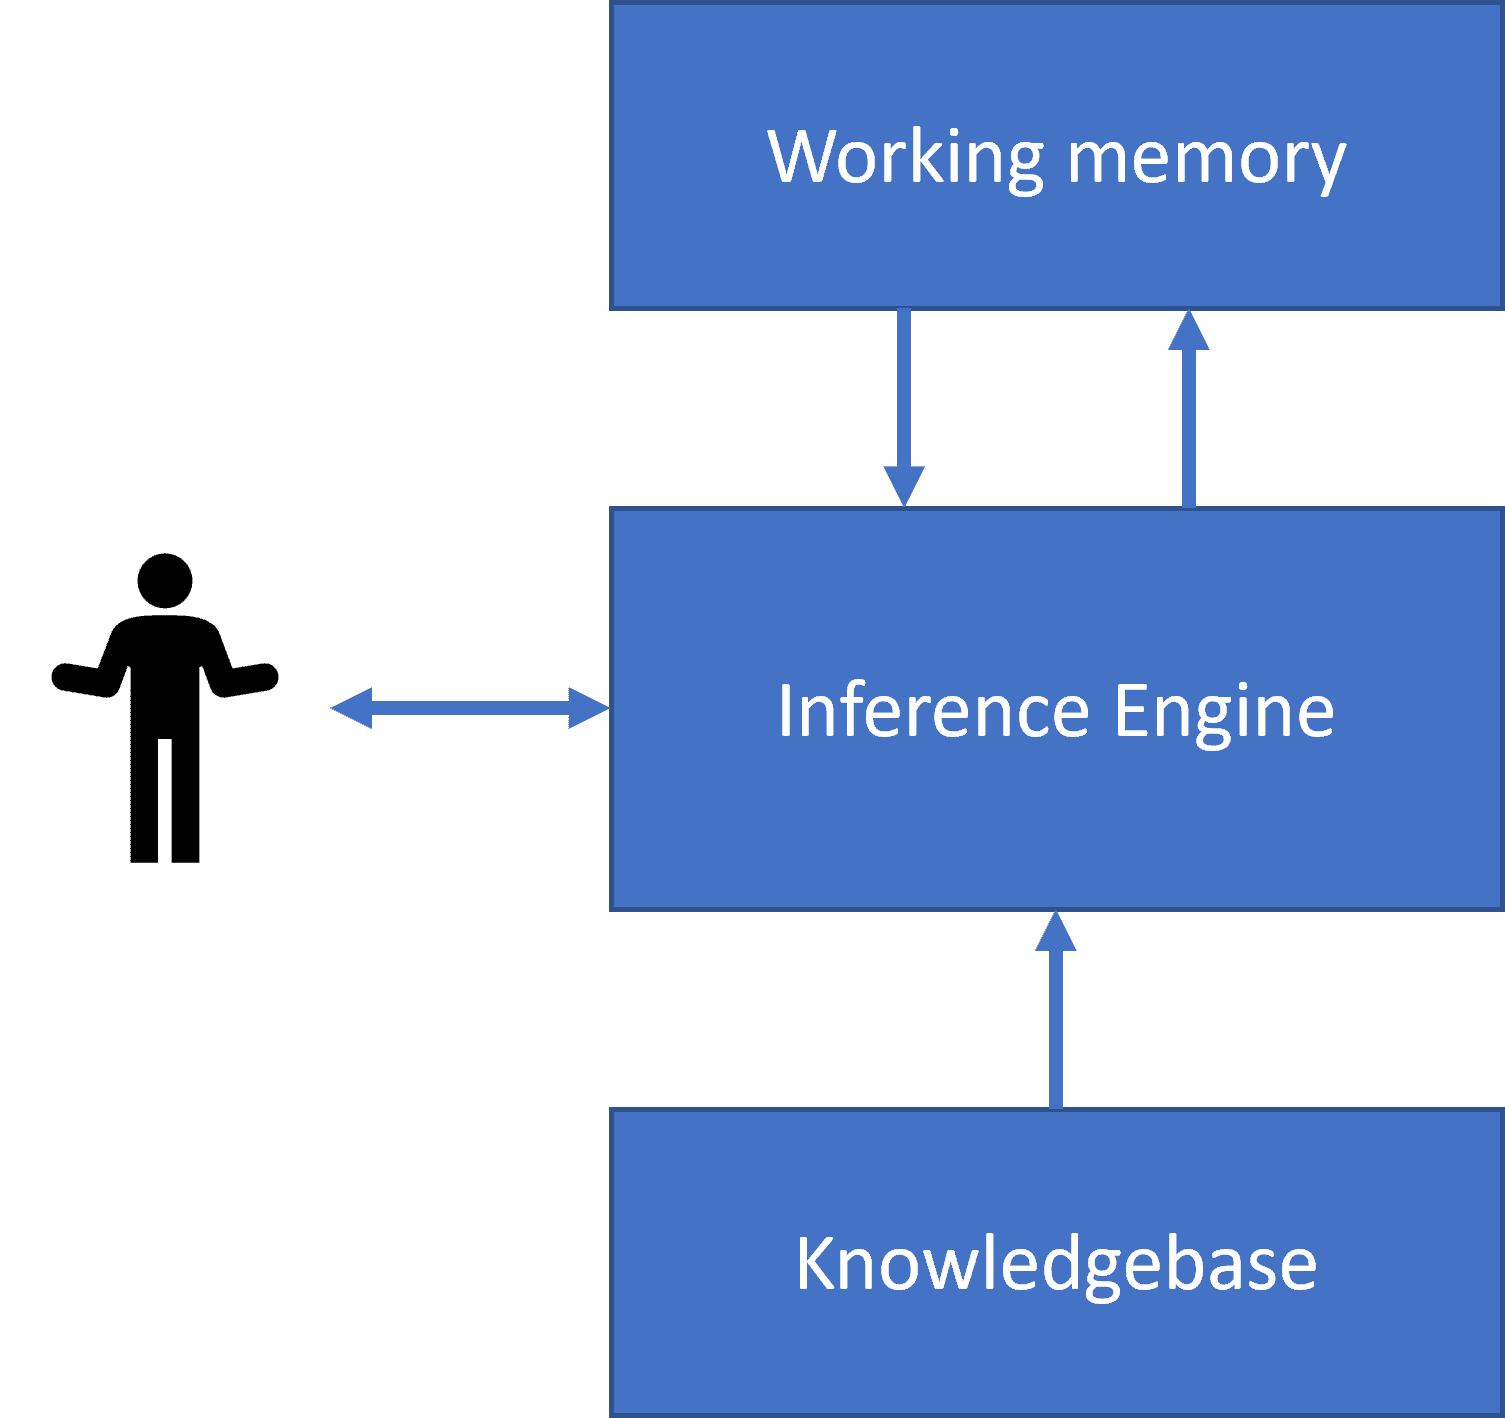
Одним из ранних успехов символического ИИ стали так называемые экспертные системы: компьютерные системы, разработанные для выполнения функций эксперта в некоторой ограниченной предметной области. Они основывались на базе знаний, извлечённой от одного или нескольких человеческих экспертов, и содержали механизм вывода, который выполнял рассуждения на её основе.
 |
 |
|---|---|
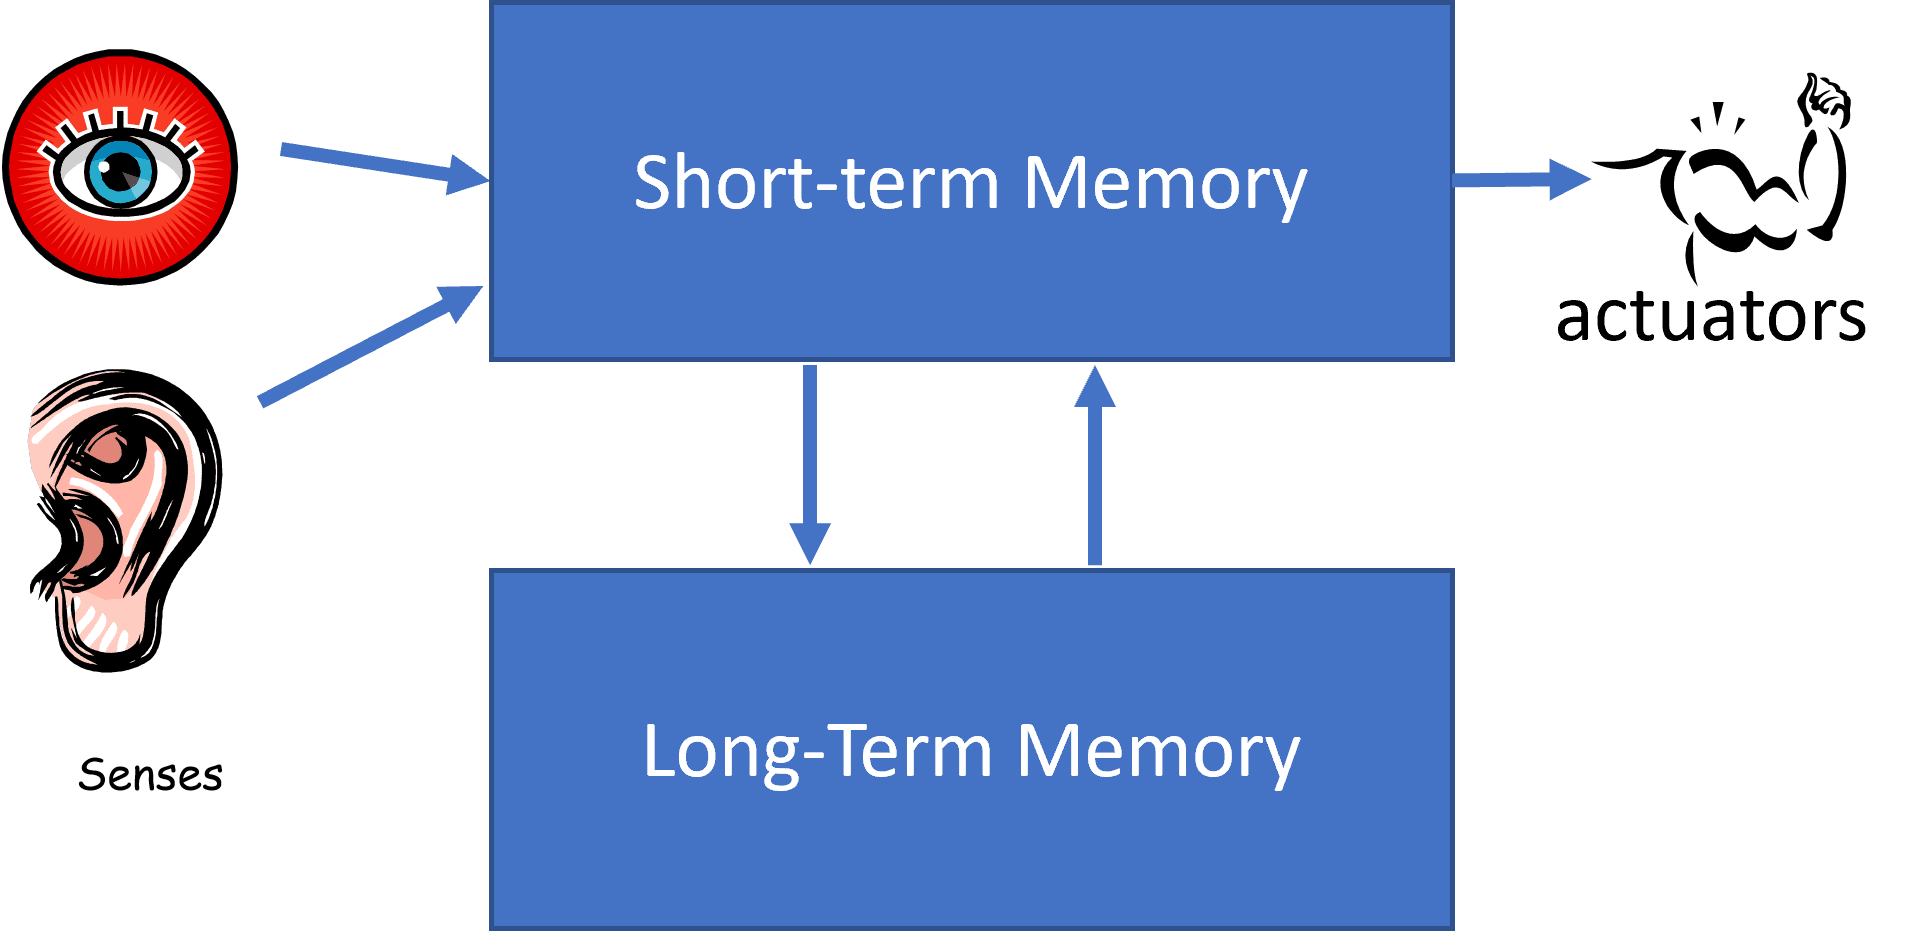
| Упрощённая структура человеческой нервной системы | Архитектура системы на основе знаний |
Экспертные системы строятся по аналогии с человеческой системой рассуждений, которая включает кратковременную память и долговременную память. Аналогично, в системах на основе знаний выделяют следующие компоненты:
- Память задачи: содержит знания о текущей решаемой задаче, например, температуру или кровяное давление пациента, наличие у него воспаления и т. д. Эти знания также называют статическими знаниями, поскольку они представляют собой снимок того, что мы в данный момент знаем о задаче, так называемое состояние задачи.
- База знаний: представляет долговременные знания о предметной области. Она извлекается вручную от человеческих экспертов и не меняется от консультации к консультации. Поскольку база знаний позволяет переходить от одного состояния задачи к другому, её также называют динамическими знаниями.
- Механизм вывода: управляет всем процессом поиска в пространстве состояний задачи, задавая пользователю вопросы при необходимости. Он также отвечает за поиск подходящих правил, которые должны быть применены к каждому состоянию.
В качестве примера рассмотрим следующую экспертную систему для определения животного на основе его физических характеристик:
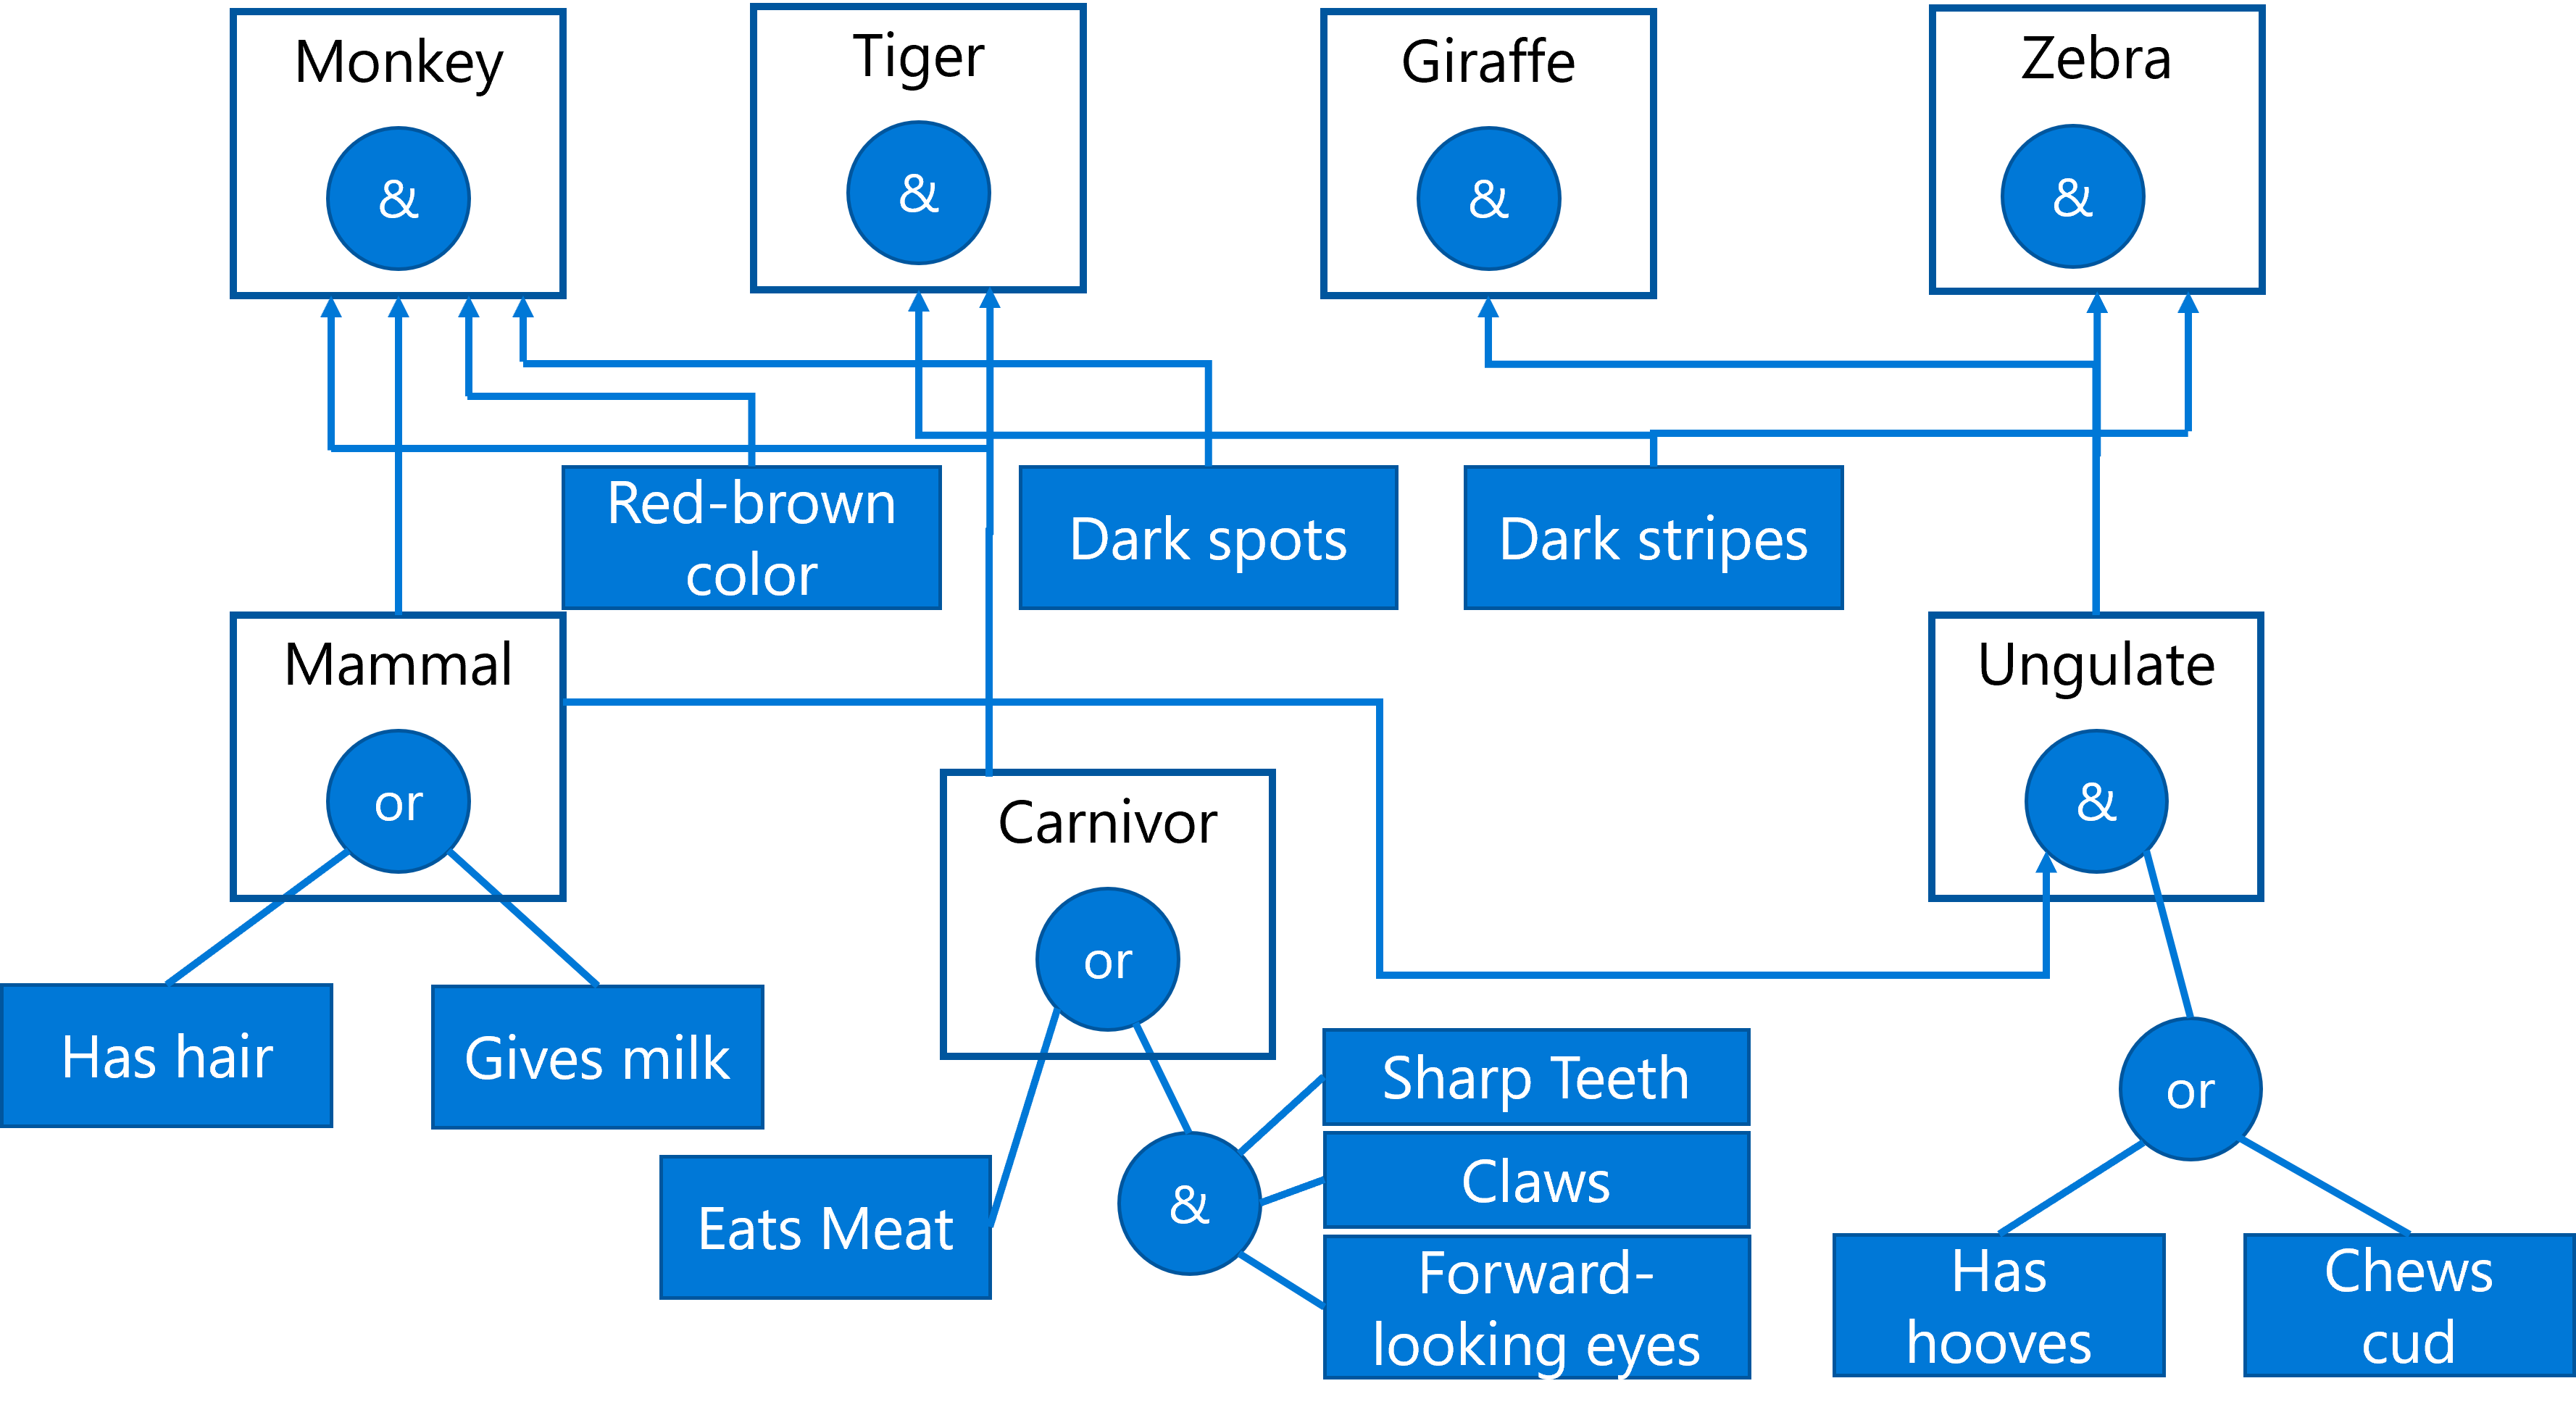
Изображение: Dmitry Soshnikov
Эта диаграмма называется AND-OR деревом и представляет собой графическое отображение набора продукционных правил. Построение дерева полезно на начальном этапе извлечения знаний от эксперта. Для представления знаний внутри компьютера удобнее использовать правила:
IF the animal eats meat
OR (animal has sharp teeth
    AND animal has claws
    AND animal has forward-looking eyes
)
THEN the animal is a carnivore
Вы можете заметить, что каждое условие в левой части правила и действие по сути являются триплетами «объект-атрибут-значение» (OAV). Рабочая память содержит набор OAV-триплетов, соответствующих текущей решаемой задаче. Механизм правил ищет правила, для которых условие удовлетворено, и применяет их, добавляя новый триплет в рабочую память.
✅ Нарисуйте собственное AND-OR дерево на любую интересующую вас тему!
Прямой и обратный вывод
Описанный выше процесс называется прямым выводом. Он начинается с некоторых исходных данных о задаче, доступных в рабочей памяти, а затем выполняет следующий цикл рассуждений:
- Если целевой атрибут присутствует в рабочей памяти, остановитесь и выдайте результат.
- Найдите все правила, условие которых в данный момент удовлетворено, получите конфликтный набор правил.
- Выполните разрешение конфликта: выберите одно правило, которое будет выполнено на этом шаге. Существуют различные стратегии разрешения конфликтов:
- Выбрать первое применимое правило в базе знаний.
- Выбрать случайное правило.
- Выбрать более специфическое правило, то есть то, которое удовлетворяет наибольшему числу условий в «левой части» (LHS).
- Примените выбранное правило и вставьте новый фрагмент знаний в состояние задачи.
- Повторите с шага 1.
Однако в некоторых случаях мы можем захотеть начать с пустых знаний о проблеме и задавать вопросы, которые помогут нам прийти к заключению. Например, при медицинской диагностике мы обычно не проводим все медицинские анализы заранее, прежде чем начать диагностировать пациента. Мы скорее хотим проводить анализы, когда необходимо принять решение.
Этот процесс можно смоделировать с помощью обратного вывода. Он управляется целью: значением атрибута, которое мы ищем:
- Выберите все правила, которые могут дать нам значение цели (то есть с целью в правой части (RHS)), это будет конфликтный набор.
- Если для этого атрибута нет правил или есть правило, которое предписывает запросить значение у пользователя, запросите его, в противном случае:
- Используйте стратегию разрешения конфликта, чтобы выбрать одно правило, которое мы будем использовать в качестве гипотезы, мы попытаемся её доказать.
- Рекурсивно повторите процесс для всех атрибутов в левой части правила, пытаясь доказать их как цели.
- Если в какой-либо момент процесс завершается неудачей, используйте другое правило на шаге 3.
✅ В каких ситуациях прямой вывод более уместен? А обратный вывод?
Реализация экспертных систем
Экспертные системы можно реализовать с помощью различных инструментов:
- Программирование их напрямую на каком-либо высокоуровневом языке программирования. Это не лучшая идея, потому что главное преимущество системы на основе знаний состоит в том, что знания отделены от механизма вывода, и эксперт в предметной области потенциально должен иметь возможность писать правила, не понимая деталей процесса вывода.
- Использование оболочки экспертной системы: системы, специально разработанной для наполнения знаниями с использованием некоторого языка представления знаний.
✍️ Упражнение: Определение животного
Пример реализации экспертной системы с прямым и обратным выводом вы найдёте в файле Animals.ipynb.
Примечание: Этот пример довольно прост и даёт лишь общее представление о том, как выглядит экспертная система. Когда вы начнёте создавать такую систему, вы заметите некоторое интеллектуальное поведение только после достижения определённого количества правил, примерно 200 и более. В какой-то момент правила становятся слишком сложными, чтобы держать их все в уме, и в этот момент вы можете начать задаваться вопросом, почему система принимает те или иные решения. Однако важной характеристикой систем на основе знаний является то, что вы всегда можете точно объяснить, как было принято любое решение.
Онтологии и Семантическая паутина
В конце XX века появилась инициатива использовать представление знаний для аннотирования интернет-ресурсов, чтобы можно было находить информацию, соответствующую очень специфическим запросам. Это движение получило название Семантическая паутина и основывалось на нескольких концепциях:
- Специальное представление знаний, основанное на дескрипционных логиках (DL). Оно похоже на фреймовое представление знаний, поскольку строит иерархию объектов со свойствами, но при этом обладает формальной логической семантикой и возможностями вывода. Существует целое семейство дескрипционных логик, которые балансируют между выразительностью и алгоритмической сложностью вывода.
- Распределённое представление знаний, где все концепты представлены глобальным URI-идентификатором, что позволяет создавать иерархии знаний, охватывающие весь интернет.
- Семейство XML-основанных языков для описания знаний: RDF (Resource Description Framework), RDFS (RDF Schema), OWL (Ontology Web Language).
Ключевое понятие в Семантической паутине: онтология. Под онтологией понимают явную спецификацию предметной области с использованием некоторого формального представления знаний. Простейшая онтология может представлять собой просто иерархию объектов в предметной области, но более сложные онтологии будут включать правила, которые можно использовать для вывода.
В Семантической паутине все представления основаны на триплетах. Каждый объект и каждое отношение уникально идентифицируются URI. Например, если мы хотим зафиксировать факт, что этот учебный план по ИИ был разработан Дмитрием Сошниковым 1 января 2022 года, вот какие триплеты мы можем использовать:
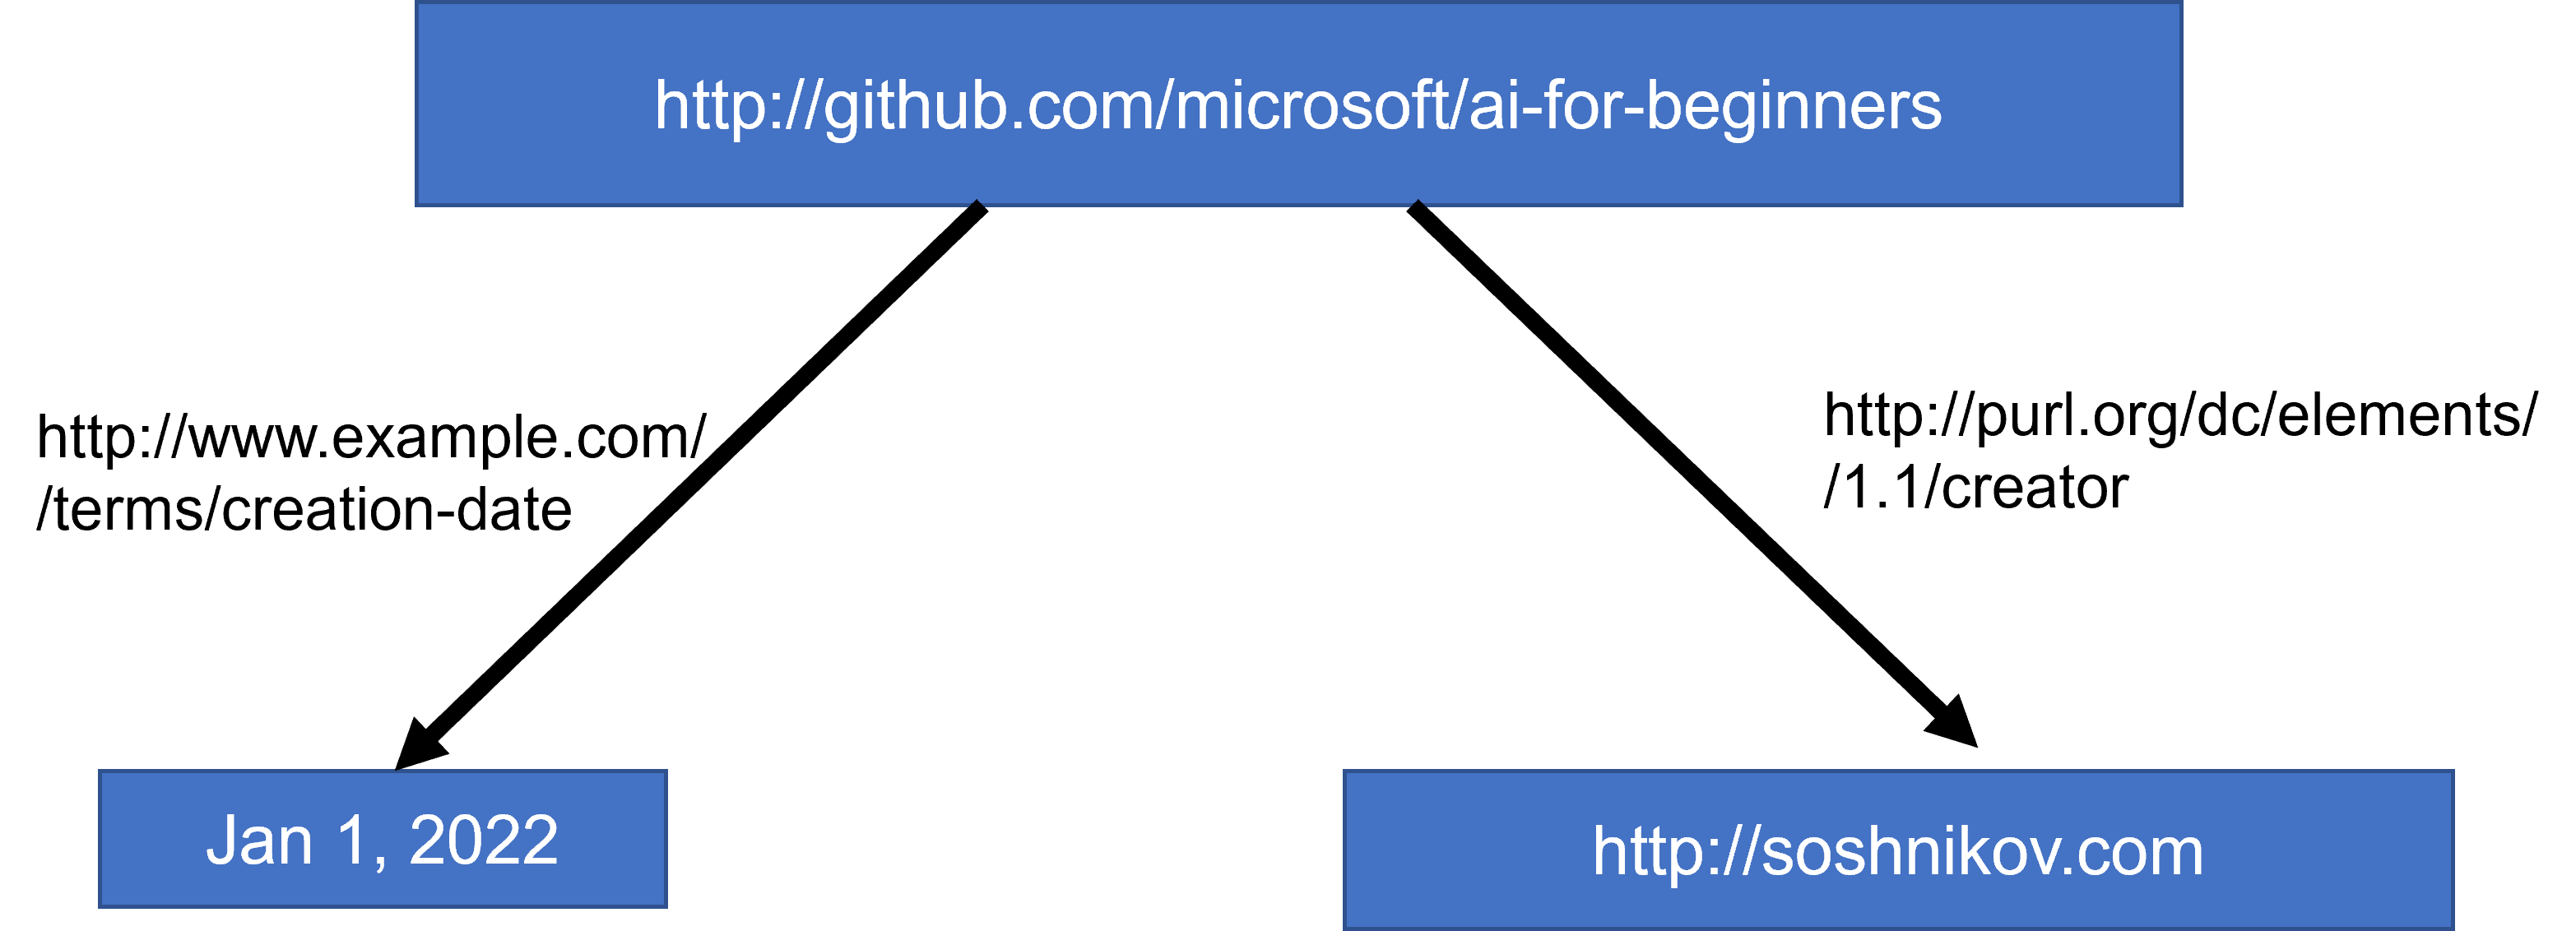
http://github.com/microsoft/ai-for-beginners http://www.example.com/terms/creation-date “Jan 1, 2022”
http://github.com/microsoft/ai-for-beginners http://purl.org/dc/elements/1.1/creator http://soshnikov.com
✅ Здесь
http://www.example.com/terms/creation-dateиhttp://purl.org/dc/elements/1.1/creator: это хорошо известные и общепринятые URI для выражения понятий создатель и дата создания.
В более сложном случае, если мы хотим определить список создателей, мы можем использовать некоторые структуры данных, определённые в RDF.
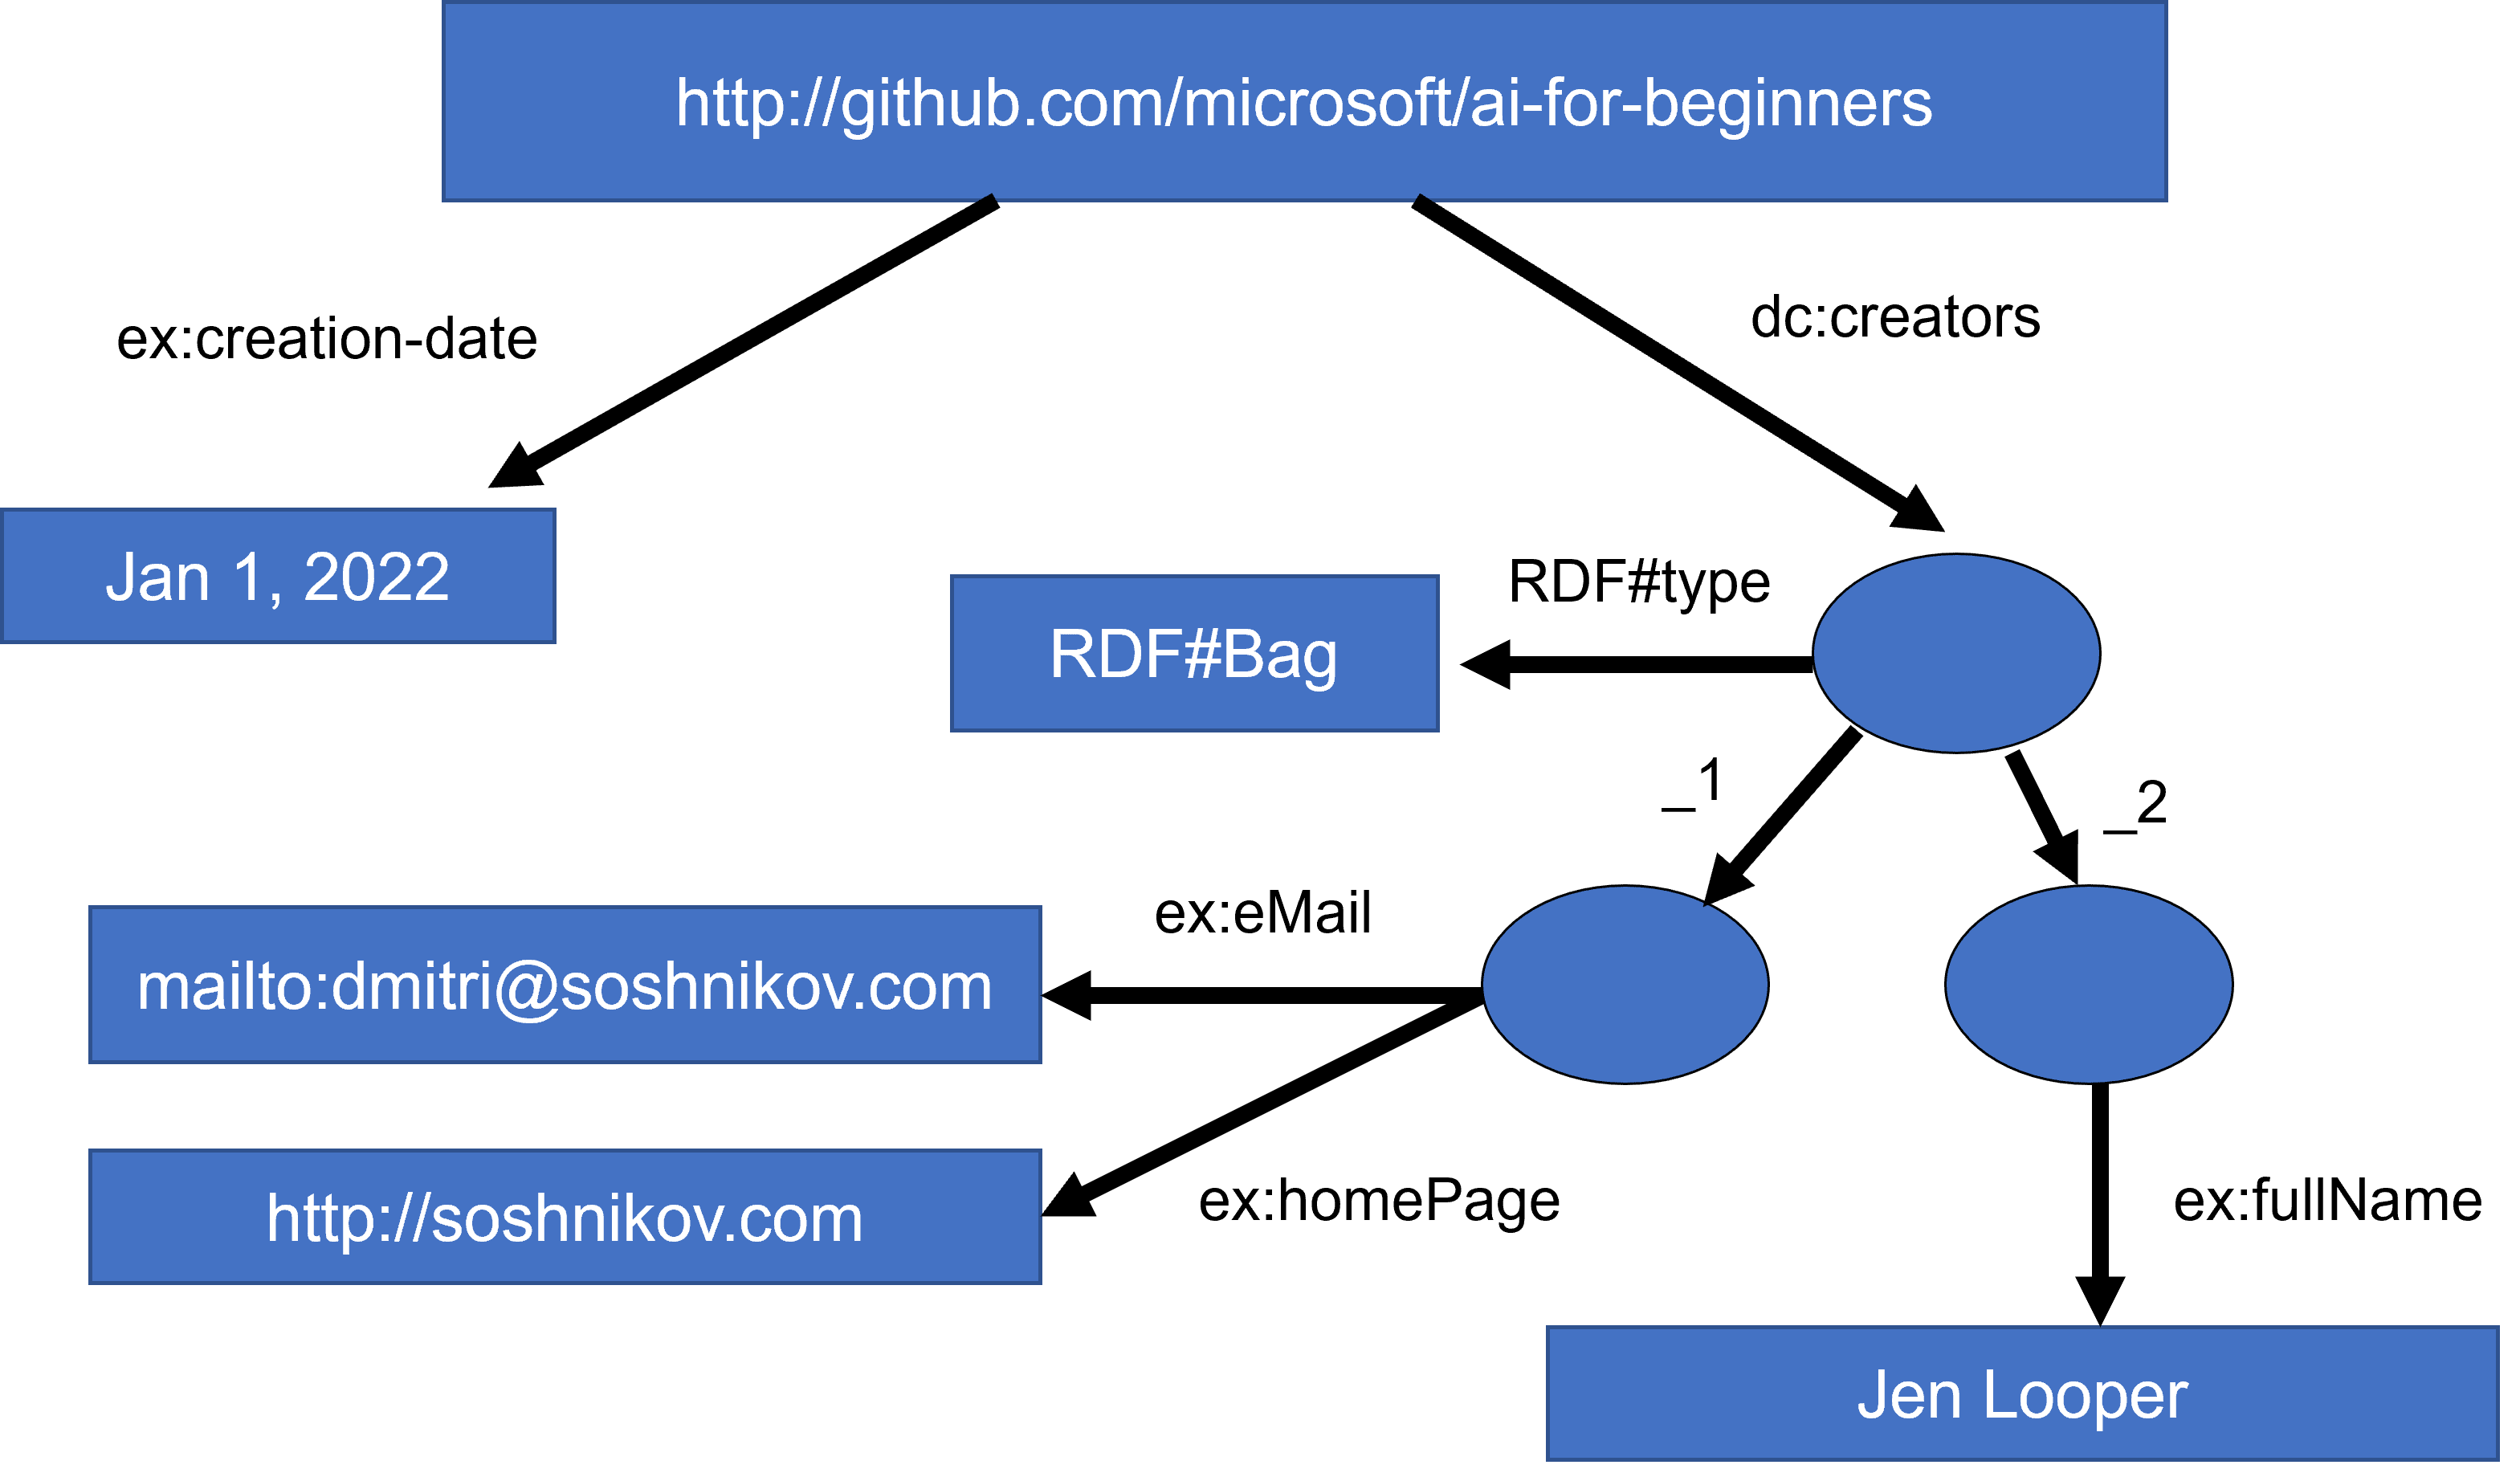
Диаграммы выше: Дмитрий Сошников
Прогресс в создании Семантической паутины несколько замедлился из-за успеха поисковых систем и методов обработки естественного языка, которые позволяют извлекать структурированные данные из текста. Однако в некоторых областях по-прежнему прилагаются значительные усилия для поддержания онтологий и баз знаний. Несколько проектов, заслуживающих внимания:
- WikiData: это коллекция машиночитаемых баз знаний, связанных с Википедией. Большая часть данных извлекается из инфобоксов Википедии, фрагментов структурированного контента на страницах Википедии. Вы можете запрашивать WikiData на SPARQL, специальном языке запросов для Семантической паутины. Вот пример запроса, который отображает самые популярные цвета глаз среди людей:
#defaultView:BubbleChart
SELECT ?eyeColorLabel (COUNT(?human) AS ?count)
WHERE
{
  ?human wdt:P31 wd:Q5.       # human instance-of homo sapiens
  ?human wdt:P1340 ?eyeColor. # human eye-color ?eyeColor
  SERVICE wikibase:label { bd:serviceParam wikibase:language "en". }
}
GROUP BY ?eyeColorLabel
- DBpedia, ещё одна инициатива, аналогичная WikiData.
✅ Если вы хотите поэкспериментировать с созданием собственных онтологий или открытием существующих, есть отличный визуальный редактор онтологий под названием Protégé. Скачайте его или используйте онлайн.
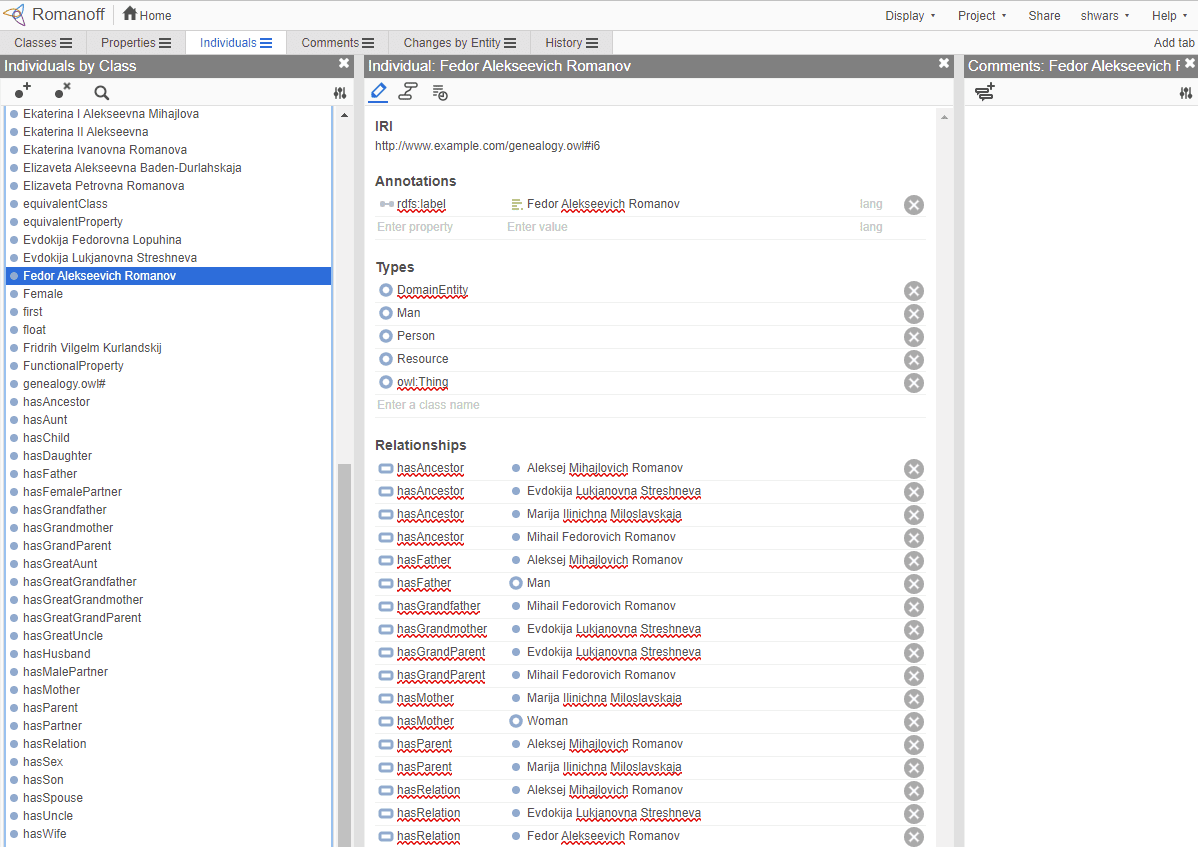
Веб-редактор Protégé открыт с онтологией семьи Романовых. Скриншот Дмитрия Сошникова
✍️ Упражнение: Семейная онтология
См. FamilyOntology.ipynb для примера использования методов Семантической паутины для рассуждений о семейных отношениях. Мы возьмём генеалогическое древо, представленное в распространённом формате GEDCOM, и онтологию семейных отношений, чтобы построить граф всех семейных связей для заданного набора людей.
Microsoft Concept Graph
В большинстве случаев онтологии тщательно создаются вручную. Однако также возможно извлекать онтологии из неструктурированных данных, например, из текстов на естественном языке.
Одна из таких попыток была предпринята Microsoft Research и привела к созданию Microsoft Concept Graph.
Это большая коллекция сущностей, сгруппированных с использованием отношения наследования is-a. Она позволяет отвечать на вопросы вроде «Что такое Microsoft?», ответом будет что-то вроде «компания с вероятностью 0.87 и бренд с вероятностью 0.75».
Граф доступен либо как REST API, либо как большой загружаемый текстовый файл, который содержит все пары сущностей.
✍️ Упражнение: Граф концепций
Попробуйте блокнот MSConceptGraph.ipynb, чтобы увидеть, как мы можем использовать Microsoft Concept Graph для группировки новостных статей по нескольким категориям.
Заключение
В настоящее время ИИ часто считается синонимом машинного обучения или нейронных сетей. Однако человек также демонстрирует явное рассуждение, что в настоящее время не обрабатывается нейронными сетями. В реальных проектах явное рассуждение по-прежнему используется для выполнения задач, требующих объяснений или возможности контролируемым образом изменять поведение системы.
🚀 Задание
В блокноте «Семейная онтология», связанном с этим уроком, есть возможность поэкспериментировать с другими семейными отношениями. Попробуйте обнаружить новые связи между людьми в генеалогическом древе.
Викторина после лекции
Обзор и самостоятельное изучение
Проведите исследование в интернете, чтобы обнаружить области, где люди пытались количественно описать и кодифицировать знания. Ознакомьтесь с таксономией Блума и вернитесь к истории, чтобы узнать, как люди пытались осмыслить свой мир. Изучите работу Линнея по созданию таксономии организмов и обратите внимание на то, как Дмитрий Менделеев создал способ описания и группировки химических элементов. Какие ещё интересные примеры вы можете найти?
Задание: Создайте онтологию
Источник: урок курса Microsoft «AI for Beginners», © Microsoft Corporation, лицензия MIT. Перевод и адаптация на русский: AI University. Мы не являемся официальным партнёром или представителем Microsoft.