О чём урок
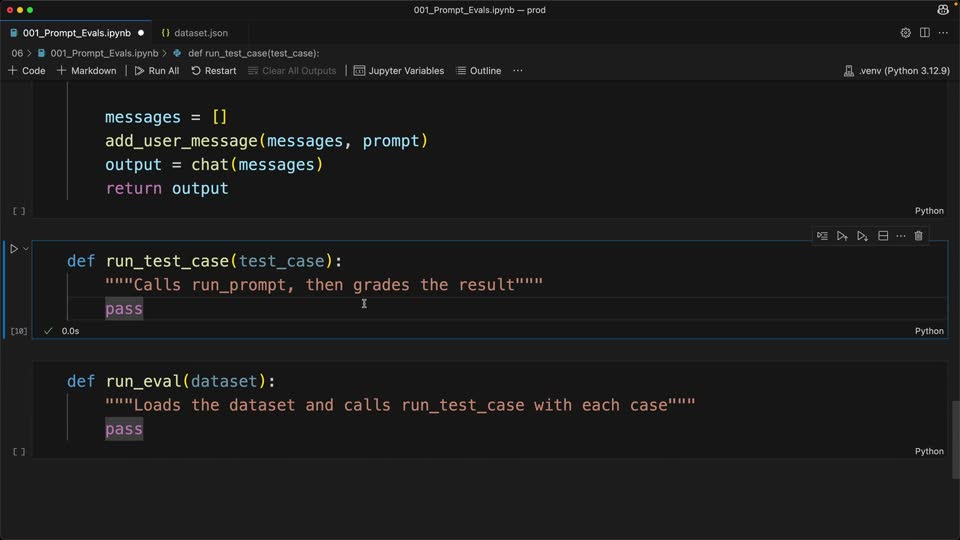
В мире разработки искусственного интеллекта, особенно при работе с большими языковыми моделями (LLM) вроде Claude, недостаточно просто создать модель, которая генерирует текст. Крайне важно постоянно оценивать качество её ответов, чтобы убедиться, что она работает так, как ожидается, и улучшать её производительность. Именно для этого служит процесс оценки, или evaluation (eval). Представьте, что у вас есть набор тестовых сценариев — вопросов или задач, на которые Claude должен ответить. Цель оценки — систематически пропустить каждый из этих сценариев через Claude, получить ответы, а затем объективно определить, насколько хороши эти ответы. Это позволяет нам понять сильные и слабые стороны модели, а также измерить прогресс по мере внесения изменений в промпты или саму модель. Процесс оценки следует четкому, повторяемому рабочему процессу. Он начинается с подготовленного набора данных (dataset), содержащего множество тестовых случаев (test cases). Каждый тестовый случай представляет собой отдельную задачу или вопрос, который мы хотим задать Claude. Далее, каждый тестовый случай объединяется с нашим шаблоном промпта (prompt template). Шаблон промпта — это заранее определенная структура, которая направляет Claude, предоставляя ему контекст и инструкции. Объединяя тестовый случай с шаблоном, мы формируем полный запрос, готовый для отправки в Claude. После того как Claude обработает запрос и сгенерирует ответ, этот ответ передается в систему оценки (grader system). Задача системы оценки — проанализировать выходные данные Claude и присвоить им балл или оценку, отражающую их качество, точность или соответствие заданным критериям. Этот балл является ключевым показателем эффективности Claude для данного тестового случая. Для автоматизации этого процесса мы строим конвейер оценки (evaluation pipeline), состоящий из нескольких взаимосвязанных функций. Рассмотрим три основные функции, которые формируют ядро такого конвейера. Эта функция отвечает за выполнение одного запроса к Claude. Она принимает на вход один тестовый случай и объединяет его с нашим шаблоном промпта.
План урока
- Запуск оценки (eval) ответов Claude
- Основной процесс оценки
- Ключевые компоненты конвейера оценки
- Функция run_prompt: Выполнение индивидуального запроса
- Функция run_test_case: Оркестрация одного тестового случая
- Функция run_eval: Обработка всего набора данных
- Выполнение оценки
- Анализ результатов
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.