О чём урок
В мире больших языковых моделей (LLM), таких как Claude, способность извлекать точную и актуальную информацию из обширных баз знаний является ключевой для создания по-настоящему полезных приложений. Технология Retrieval Augmented Generation (RAG) позволяет LLM обращаться к внешним источникам данных, чтобы генерировать ответы, основанные на фактах. Однако эффективность RAG напрямую зависит от качества механизма извлечения информации. В этом уроке мы рассмотрим продвинутый гибридный подход к поиску, который объединяет сильные стороны различных методов для достижения беспрецедентной точности.
При создании систем RAG разработчики часто сталкиваются с выбором между различными стратегиями поиска. Двумя наиболее распространенными являются семантический поиск и лексический поиск.
- Семантический поиск (на основе векторных представлений, или vector embeddings) превосходно понимает смысл запроса, даже если он не содержит точных ключевых слов. Он может находить релевантные документы, используя синонимы, контекст и общую идею. Например, запрос "стоимость поездки" может найти документы о "цене билета" или "тарифах на проезд". Однако иногда он может быть слишком "креативным" и возвращать результаты, которые семантически близки, но не содержат точных терминов, необходимых для конкретного ответа.
- Лексический поиск (например, с использованием алгоритма BM25) фокусируется на точном совпадении ключевых слов. Он очень эффективен, когда пользователь ищет конкретные термины или фразы. Например, если вы ищете "отчет INC-2023-Q4-011", BM25 быстро найдет документы, содержащие именно этот идентификатор. Его недостаток в том, что он плохо справляется с синонимами или запросами, сформулированными иначе, чем текст в документах.
Каждый из этих методов имеет свои сильные стороны и ограничения. Идея гибридного подхода заключается в том, чтобы объединить их, используя преимущества обоих и компенсируя их недостатки, тем самым обеспечивая более точные и полные результаты поиска.
Когда у нас есть две независимые реализации поиска — VectorIndex для семантического поиска и BM25Index для лексического, — следующим шагом является их объединение в единый конвейер. Этот гибридный подход использует сильные стороны обоих методов для получения более точных результатов. Ключевым элементом здесь является класс-координатор, который мы назовем Retriever.
План урока
- Ограничения Традиционного Поиска и Необходимость Гибридного Подхода
- Архитектура Гибридного Поиска: Координатор Retriever
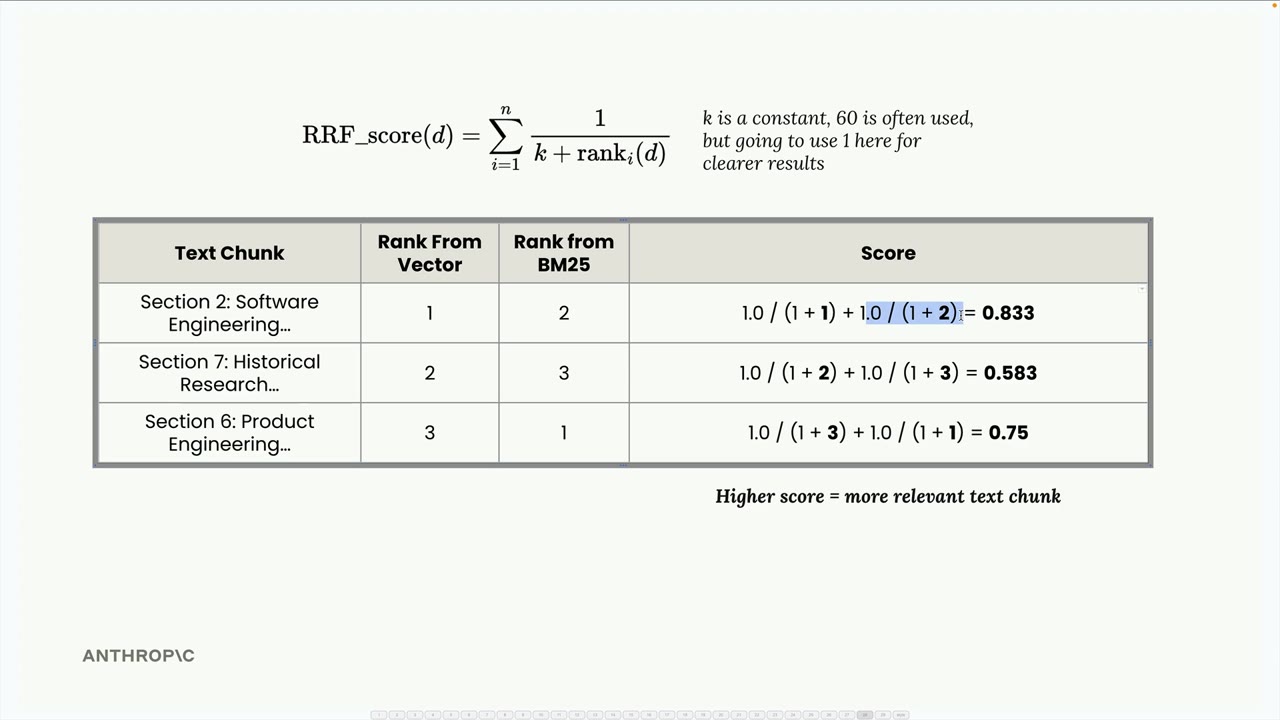
- Объединение Результатов: Алгоритм Reciprocal Rank Fusion (RRF)
- Преимущества и Модульность Гибридного Подхода
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.