О чём урок
В мире больших языковых моделей (LLM) и систем генерации с дополненной выборкой (RAG) способность эффективно извлекать релевантную информацию имеет решающее значение. Однако одним из фундаментальных вызовов при работе с RAG-пайплайнами является проблема потери контекста. Когда вы разбиваете большой документ на более мелкие фрагменты (chunks) для индексации, каждый фрагмент, хотя и содержит ценную информацию, теряет свою связь с общим контекстом документа. Это похоже на попытку собрать пазл, имея лишь отдельные кусочки, но не видя всей картины. Контекстный поиск (Contextual retrieval) — это мощная техника, разработанная для решения этой проблемы. Она значительно повышает точность RAG-пайплайнов, позволяя каждому фрагменту текста сохранять и даже усиливать свою связь с более широким документом, из которого он был извлечен. В этом уроке мы подробно рассмотрим, как работает контекстный поиск, почему он важен и как его можно реализовать с помощью Claude в Amazon Bedrock. Стандартный подход в RAG-системах включает в себя разбиение исходных документов на управляемые фрагменты. Эти фрагменты затем индексируются (например, в векторной базе данных или с помощью алгоритмов BM25) и используются для поиска наиболее релевантных частей документа в ответ на пользовательский запрос. Проблема заключается в том, что, хотя каждый фрагмент может быть семантически плотным, он редко содержит всю необходимую информацию для понимания его места и значения в рамках всего документа. Например, фрагмент может упоминать "Проект Феникс" или "ИНЦ-2023-04-011". Без дополнительного контекста система извлечения может не понять, что "Проект Феникс" — это инициатива по разработке программного обеспечения, а "ИНЦ-2023-04-011" — это идентификатор инцидента, который также упоминается в разделе "Анализ кибербезопасности" другого документа. Эта потеря связей приводит к менее точным результатам поиска, поскольку система не может полностью оценить релевантность фрагмента, основываясь только на его внутреннем содержании. Основная идея контекстного поиска проста, но эффективна: перед тем как сохранить фрагменты документа в базе данных для извлечения, мы просим Claude добавить к каждому фрагменту дополнительный контекст.
План урока
- Введение в контекстный поиск
- Почему контекст имеет значение: проблема фрагментации документов в RAG
- Как работает контекстный поиск с Claude
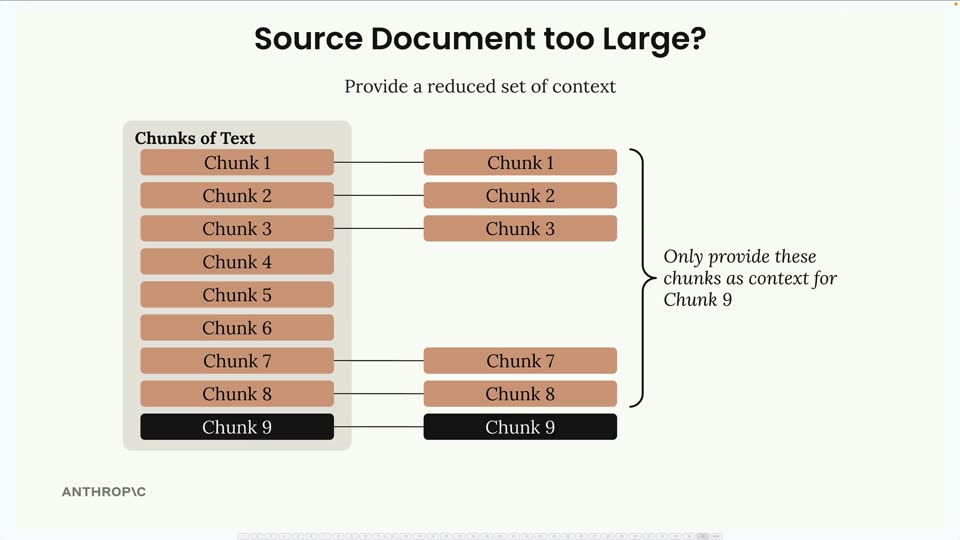
- Обработка больших документов с ограниченным контекстом
- Ожидаемые результаты и преимущества контекстного поиска
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.