О чём урок
В мире больших языковых моделей (LLM), таких как Claude, эффективность и скорость обработки запросов играют ключевую роль. Одной из инновационных функций, разработанных для оптимизации этого процесса, является кэширование промптов (Prompt caching). Эта функция значительно ускоряет ответы Claude и снижает затраты на генерацию текста, повторно используя вычислительную работу, выполненную в предыдущих запросах. Чтобы понять, как это работает, давайте сначала рассмотрим, что обычно происходит внутри Claude во время типичного запроса.
Когда вы отправляете сообщение Claude, за кулисами происходит множество сложных операций, прежде чем вы получите ответ. Claude не начинает немедленно генерировать текст; сначала он выполняет обширную работу по обработке вашего входного сообщения. Этот этап предварительной обработки критически важен для понимания и формирования адекватного ответа.
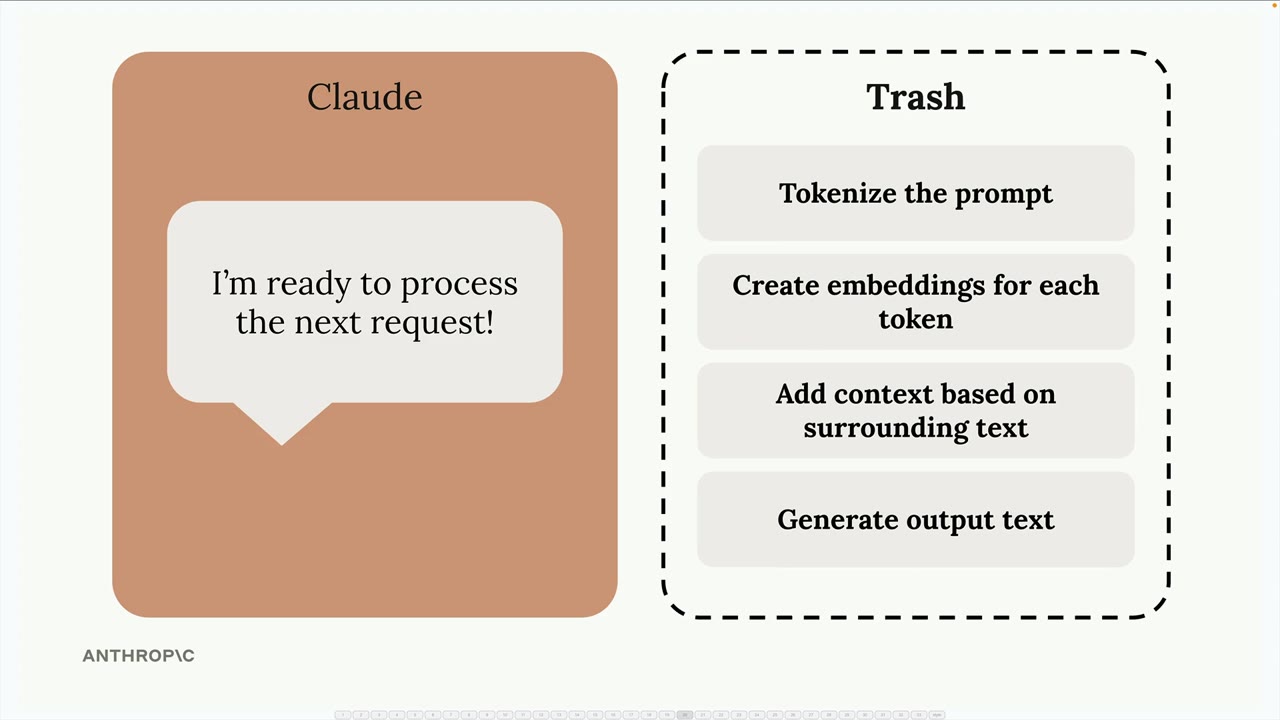
Вот основные шаги, которые Claude выполняет с вашим сообщением:
- Токенизация промпта (Tokenize the prompt): Сначала входной текст разбивается на более мелкие единицы, называемые token'ами. Это могут быть слова, части слов или даже отдельные символы, в зависимости от языка и модели.
- Создание эмбеддингов для каждого токена (Create embeddings for each token): Каждый token преобразуется в числовой вектор (embedding), который представляет его семантическое значение. Эти векторы позволяют модели понимать отношения между словами и их контекст.
- Добавление контекста на основе окружающего текста (Add context based on surrounding text): Модель анализирует embedding'и в их последовательности, чтобы понять общий смысл промпта и установить связи между различными частями текста. Это включает в себя механизмы внимания (как в архитектуре transformer), которые позволяют модели взвешивать важность различных token'ов относительно друг друга.
- Генерация выходного текста (Generate output text): Только после завершения всей этой предварительной обработки Claude приступает к генерации самого ответа, token за token'ом.
Вся эта вычислительная работа по предварительной обработке происходит до того, как Claude сгенерирует какой-либо фактический ответ. Однако, как только Claude завершает обработку вашего запроса и отправляет ответ, он обычно отбрасывает всю только что выполненную вычислительную работу.
Отбрасывание всей проделанной работы создает неэффективность, особенно…
План урока
- Кэширование промптов: Ускорение и оптимизация работы с Claude
- Как Claude обрабатывает запросы без кэширования
- Проблема повторной обработки информации
- Как кэширование промптов решает эту проблему
- Преимущества и особенности кэширования промптов
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.