О чём урок
При работе с большими языковыми моделями (LLM), такими как Claude, часто возникает потребность в генерации структурированных данных. Будь то код на Python, формат JSON для API, списки с маркировкой или другие специфические форматы, вы ожидаете получить чистый, готовый к использованию вывод. Однако Claude, будучи чрезвычайно полезным и разговорчивым помощником, имеет естественную склонность добавлять пояснительный текст, вступления или заключения к своим ответам. Хотя это обычно очень ценно для интерактивного общения, в сценариях автоматизации или при интеграции с приложениями такой "лишний" текст становится серьезной проблемой.
Представьте, что вы разрабатываете веб-приложение, которое генерирует правила для AWS EventBridge. Пользователь вводит описание желаемого правила, нажимает кнопку "сгенерировать" и ожидает получить чистый JSON, который можно немедленно скопировать и использовать. Если Claude возвращает JSON, обернутый в блоки разметки markdown (например, ```json ... ```) с дополнительными заголовками вроде "Вот ваше правило EventBridge:" и подписями, пользователь не сможет просто нажать "копировать все". Ему придется вручную выделять только часть с JSON, что снижает удобство использования и эффективность.
Эта проблема возникает всякий раз, когда вы работаете со структурированными данными. Claude естественным образом стремится объяснить свою работу и предоставить контекст, но во многих случаях вам нужен только запрошенный контент и ничего больше. К счастью, существуют мощные методы, позволяющие получить именно тот вывод, который вам нужен, с максимальной точностью.
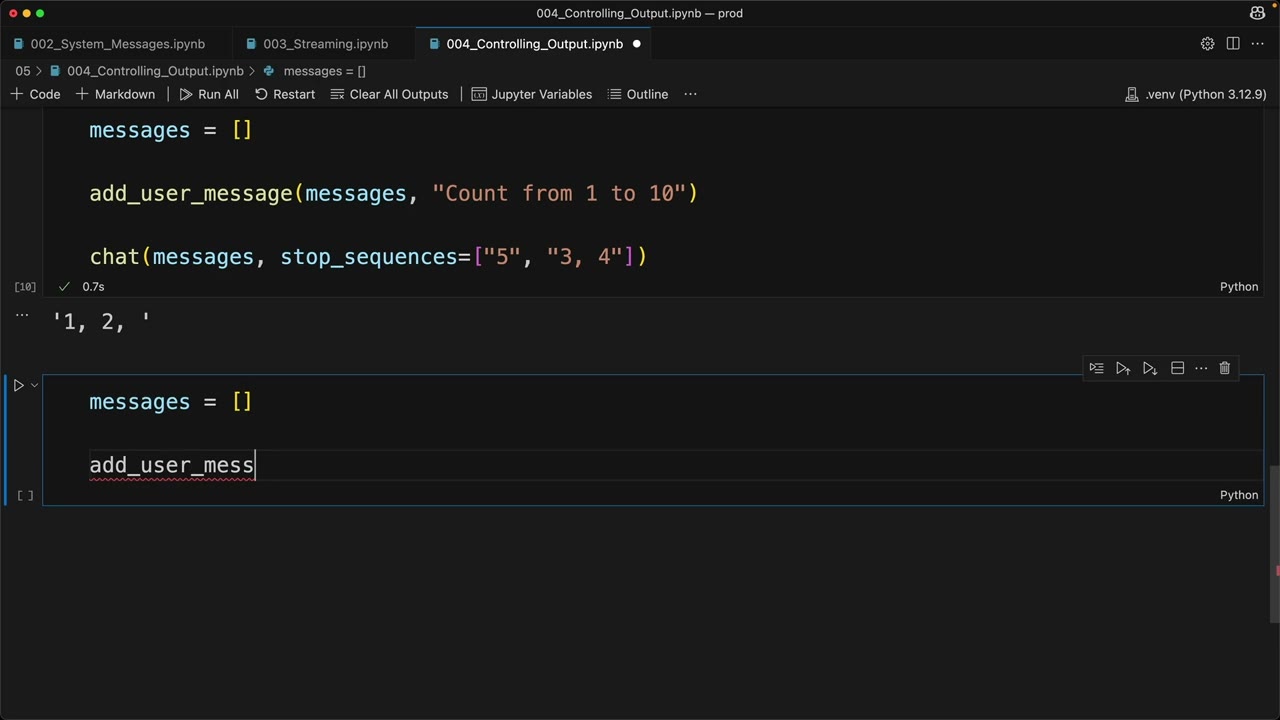
Ключ к получению чистого структурированного вывода от Claude лежит в комбинации двух техник, которые, возможно, уже знакомы вам по работе с LLM: предварительное заполнение сообщения ассистента (Assistant Message Prefilling) и последовательности останова (Stop Sequences). Вместе они позволяют точно контролировать начало и конец генерации Claude, гарантируя, что вы получите только желаемые данные.
Предварительное заполнение сообщения ассистента — это мощный способ "направить" Claude в нужное русло, прежде чем он начнет генерировать свой ответ. Вместо того чтобы позволить модели начать с нуля, вы предоставляете ей начальную часть ее собственного ответа.
Как это работает? Когда вы формируете диалог для Claude, вы…
План урока
- Управление структурированным выводом Claude: Получение точных данных без лишних слов
- Элегантное решение: Комбинация предварительного заполнения и последовательностей останова
- Техника 1: Предварительное заполнение сообщения ассистента (Assistant Message Prefilling)
- Техника 2: Последовательности останова (Stop Sequences)
- Применение на практике: Получение чистого JSON
- Как это работает "за кулисами"
- Универсальность подхода
- Заключение
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.