О чём урок
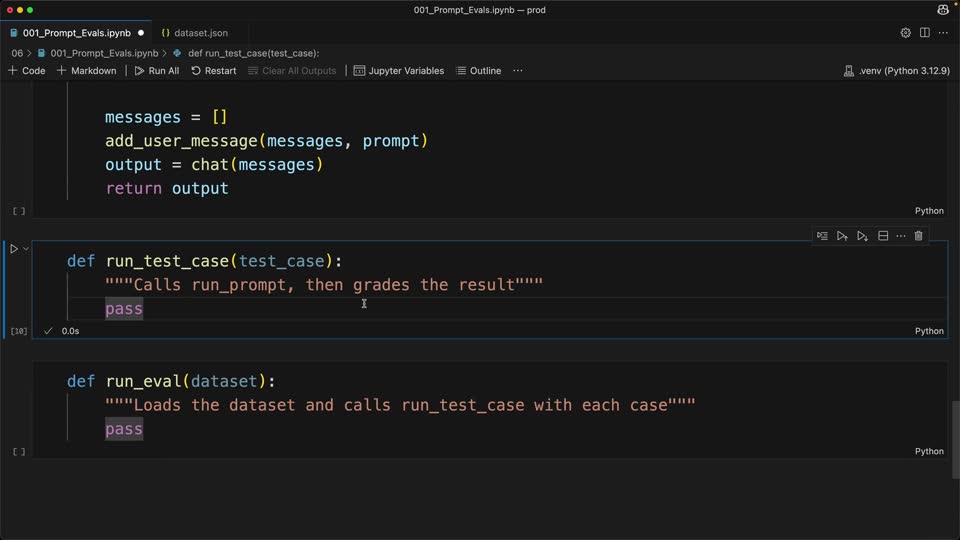
После того как мы подготовили наш набор данных для оценки, пришло время создать основной конвейер оценки (evaluation pipeline). Этот процесс включает в себя последовательную обработку каждого тестового случая: объединение его с нашим промптом, отправку в Claude и последующую оценку полученных результатов. Процесс оценки следует четкому рабочему процессу. Мы берем наш набор данных, состоящий из тестовых случаев, каждый из которых комбинируем с заранее определенным шаблоном промпта. Затем этот объединенный запрос отправляется в Claude для обработки. Полученный от Claude ответ далее оценивается с помощью специальной системы оценки, которую мы будем называть "градером" (grader). Конвейер оценки состоит из трех основных функций, каждая из которых выполняет свою специфическую задачу. Давайте начнем с самой простой из них — функции, которая обрабатывает индивидуальные промпты. Эта функция отвечает за объединение тестового случая с нашим шаблоном промпта и отправку его в Claude. Ее цель — подготовить запрос таким образом, чтобы Claude мог его понять и обработать, а затем вернуть полученный ответ. В своей простейшей форме, функция run_prompt может выглядеть следующим образом (в концептуальном плане): На данном этапе мы используем чрезвычайно простой промпт. Мы не включаем никаких инструкций по форматированию или ограничений на длину ответа, поэтому Claude, скорее всего, вернет более подробный вывод, чем нам нужно. Это нормально для начального этапа; мы будем уточнять дизайн нашего промпта по мере итераций и улучшения системы. Эта функция координирует выполнение одного тестового случая и подготовку его результата к оценке. Она вызывает функцию run_prompt, чтобы получить ответ от Claude, а затем подготавливает структуру для хранения этого ответа вместе с исходным тестовым случаем и оценкой. Концептуально, функция run_test_case работает так: На данный момент мы используем жестко заданную оценку (score = 10). Логика оценки — это та часть, которой мы уделим значительное время в следующих разделах. Однако эта "заглушка" позволяет нам протестировать общую структуру конвейера и убедиться, что все части работают вместе.
План урока
- Оценка производительности Claude: Создание базового конвейера
- Создание основных функций конвейера
- Функция run_prompt
- Функция run_test_case
- Функция run_eval
- Запуск оценки
- Анализ результатов
- Что мы достигли
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.