О чём урок
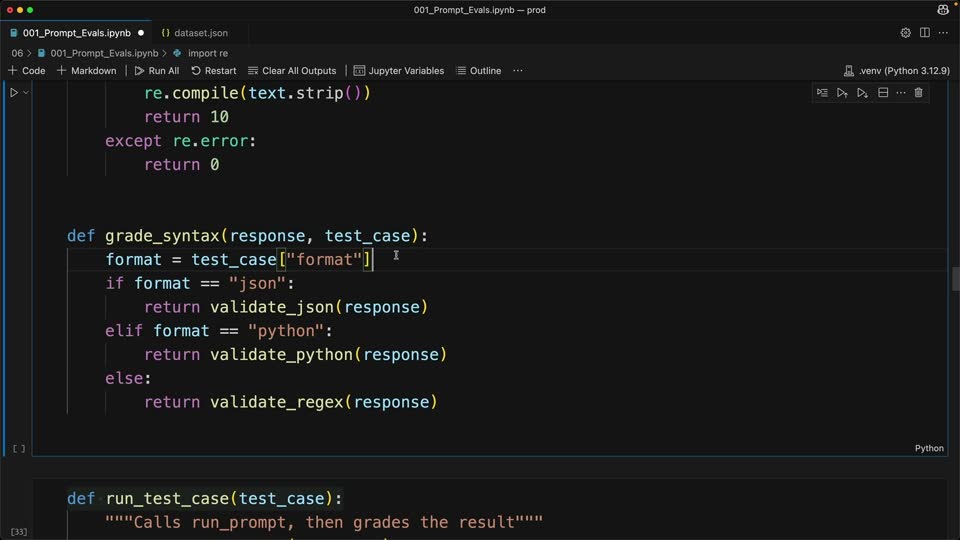
В мире больших языковых моделей (LLM), таких как Claude, способность генерировать код является одной из самых впечатляющих и полезных функций. Однако, когда речь заходит об оценке качества такого кода, простого прочтения и понимания его логики недостаточно. Код, сгенерированный ИИ, должен не только быть осмысленным, но и обладать корректным синтаксисом, соответствовать заданному формату и быть функциональным. Именно здесь на помощь приходит автоматическая оценка кода (Code-based grading). Этот подход позволяет нам выйти за рамки субъективной оценки и получить объективные метрики качества, что крайне важно для разработки и улучшения моделей, способных создавать надежный и рабочий код. Автоматическая оценка кода фокусируется на двух ключевых аспектах ответов, сгенерированных ИИ, особенно когда эти ответы должны представлять собой программный код, структуру данных или регулярные выражения: Соответствие типу: Ответ модели должен содержать только запрошенный тип кода (например, Python, JSON или Regex) без каких-либо дополнительных пояснений, комментариев или вводного текста. Синтаксическая корректность: Сгенерированный код должен быть синтаксически правильным и успешно парситься как предполагаемый язык или формат. То есть, если это Python, он должен быть валидным Python-кодом; если JSON — валидным JSON-объектом. Важно отметить, что первые два критерия обрабатываются именно системой оценки кода. Третий аспект — насколько точно ответ модели соответствует поставленной задаче и является ли он корректным по смыслу — обычно оценивается отдельной системой, которую мы называем оценщиком модели (Model grader). Совместное использование этих двух подходов обеспечивает всестороннюю и комплексную оценку качества генерации. Для проверки синтаксической корректности сгенерированного кода можно использовать специализированные функции-помощники. Эти функции пытаются разобрать (спарсить) выходные данные модели, используя стандартные библиотеки соответствующего языка или формата. Если парсинг проходит успешно, это означает, что синтаксис верен; в противном случае — есть ошибка. Рассмотрим, как это работает на примерах для различных форматов: Для JSON: Чтобы проверить, является ли строка валидным JSON-объектом, можно использовать функцию, которая пытается вызвать json.loads(). Если строка успешно преобразуется в Python-объект, это валидный JSON.
План урока
- Оценка кода, сгенерированного ИИ: Зачем нужна автоматическая проверка синтаксиса?
- Принципы работы автоматической оценки кода
- Механизмы проверки синтаксиса
- Требования к формату набора данных для оценки
- Улучшение ясности промптов для генерации кода
- Объединение оценок: Комплексный подход
- Тестирование и итеративное улучшение
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.