О чём урок
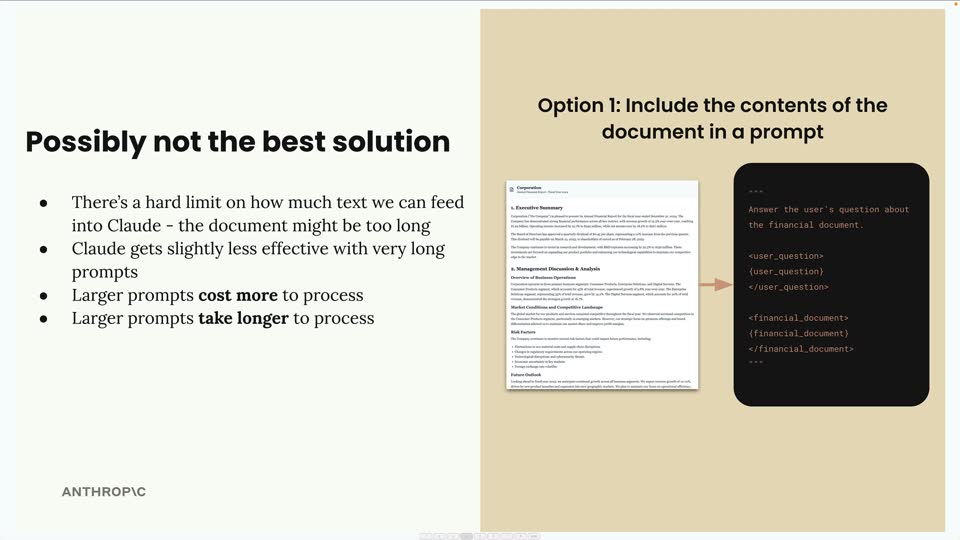
В мире больших языковых моделей (LLM), таких как Claude, работа с обширными объемами информации часто становится камнем преткновения. Представьте, что вам нужно проанализировать финансовый отчет на 800 страниц или целую библиотеку документов. Как эффективно извлечь нужные данные и представить их модели, чтобы она могла дать точный и контекстуально релевантный ответ? Именно здесь на помощь приходит техника, известная как Retrieval Augmented Generation (RAG). RAG — это мощный подход, который позволяет Claude взаимодействовать с огромными массивами данных, не "загружая" их целиком в промпт. Вместо того чтобы пытаться уместить весь 800-страничный отчет в одно сообщение, RAG интеллектуально находит и включает только наиболее релевантные разделы для каждого конкретного вопроса. Это значительно повышает эффективность, точность и экономичность работы с LLM, особенно в таких средах, как Claude с Google Vertex AI. Давайте рассмотрим типичную ситуацию. У вас есть объемный корпоративный документ, и вы хотите задать Claude конкретные вопросы, например: "Какие факторы риска присущи этой компании?" или "Какова стратегия компании по выходу на новые рынки?". Вы сталкиваетесь с фундаментальной проблемой: как передать нужную информацию из документа в Claude таким образом, чтобы модель могла эффективно ответить на ваш вопрос? Большие языковые модели, несмотря на их впечатляющие способности, имеют ограничения. Одно из ключевых — это размер контекстного окна (context window), то есть максимальное количество токенов (token), которое модель может обработать за один раз. Если ваш документ превышает этот лимит, вы не сможете просто скопировать и вставить его целиком. Первый, казалось бы, самый простой подход — это извлечь весь текст из документа и поместить его непосредственно в ваш промпт вместе с вопросом пользователя. На первый взгляд это кажется логичным решением, но на практике такой метод сталкивается с рядом серьезных проблем: Ограничение на размер текста: Как уже упоминалось, у Claude есть жесткий лимит на количество токенов, которое он может обработать. Ваш документ, скорее всего, будет слишком длинным, чтобы поместиться в этот лимит.
План урока
- Введение в Retrieval Augmented Generation (RAG)
- Проблема больших документов для LLM
- Подход 1: Включение всего в промпт
- Подход 2: Разделение документов на фрагменты (Retrieval Augmented Generation)
- Преимущества подхода с фрагментацией (RAG)
- Вызовы и нюансы RAG
- Ключевые компоненты RAG
- Когда использовать RAG
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.