О чём урок
В мире больших языковых моделей (LLM), таких как Claude, способность получать точную и актуальную информацию из обширных баз знаний является ключевой для создания по-нанастоящему полезных и надежных приложений. Этот процесс, известный как Retrieval Augmented Generation (RAG), значительно улучшает качество ответов LLM, предоставляя им контекст из внешних источников. Однако эффективность RAG напрямую зависит от качества механизма поиска (retrieval). Традиционно, для поиска информации используются два основных подхода: лексический и семантический. Каждый из них имеет свои сильные стороны и ограничения. Представьте, что у вас есть огромная библиотека, и вам нужно найти конкретную книгу. Лексический поиск похож на поиск по ключевым словам в каталоге, а семантический — на поиск по смыслу или теме. Но что, если мы могли бы объединить их, чтобы получить лучшее из обоих миров? Именно это и предлагает многоиндексный RAG-конвейер, создавая гибридный подход, который значительно повышает точность и релевантность извлекаемой информации. Прежде чем говорить об объединении, давайте кратко рассмотрим два фундаментальных метода поиска: Лексический поиск (например, BM25): Этот метод фокусируется на точном совпадении ключевых слов. Он анализирует частоту слов в документе и их распределение, чтобы определить релевантность. BM25 — это популярный алгоритм, который отлично справляется с поиском документов, содержащих конкретные термины. Преимущества: Эффективен для точных запросов, хорошо работает с уникальными идентификаторами или специфическими терминами. Он не требует сложных вычислений для понимания смысла. Недостатки: Не учитывает синонимы, контекст или смысловую близость. Если запрос использует другие слова, но с тем же значением, BM25 может пропустить релевантные документы. Семантический поиск (на основе векторных эмбеддингов): Этот подход использует мощь нейронных сетей для преобразования текста (запросов и документов) в числовые векторы, называемые embeddings. Документы, которые семантически похожи, будут иметь векторы, расположенные близко друг к другу в многомерном пространстве. Поиск сводится к нахождению векторов документов, наиболее близких к вектору запроса (например, с использованием косинусного сходства).
План урока
- Многоиндексный RAG-конвейер: Объединяя Силу Поиска для Claude с Google Vertex AI
- Понимание Проблемы Поиска: Лексический и Семантический Подходы
- Объединение Лучшего: Гибридный Подход к Поиску
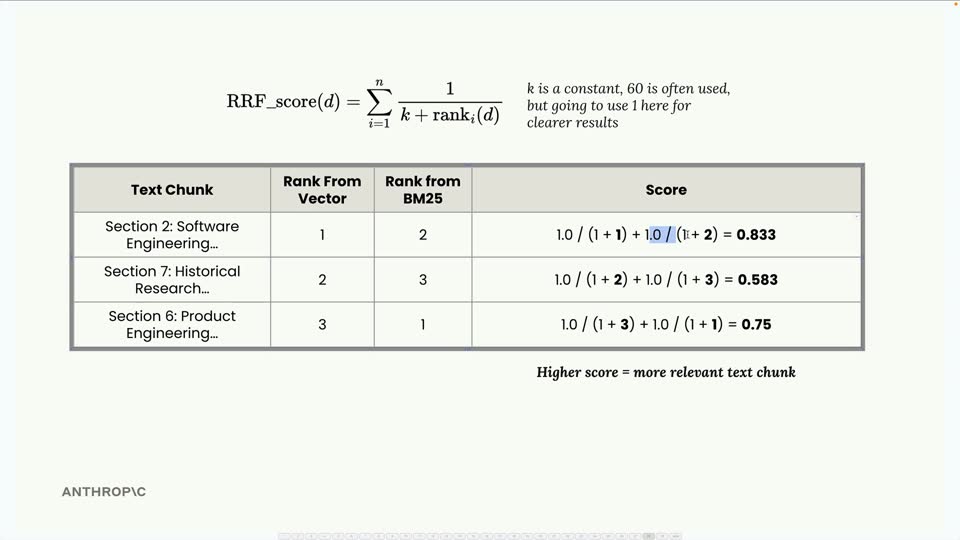
- Решение Проблемы Слияния: Reciprocal Rank Fusion (RRF)
- Архитектура Гибридного Поиска: Класс Retriever
- Преимущества Гибридной Архитектуры
- Заключение
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.