О чём урок
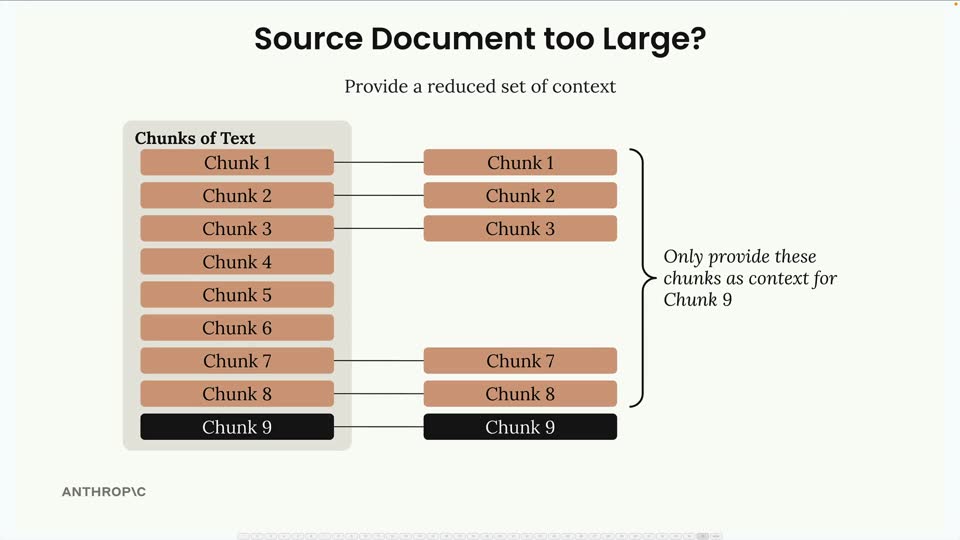
Контекстный поиск (Contextual Retrieval) В мире больших языковых моделей (Large Language Models, LLM) и систем генерации с дополненным поиском (Retrieval Augmented Generation, RAG) способность предоставлять точные и релевантные ответы напрямую зависит от качества извлекаемой информации. Стандартный подход к подготовке документов для векторных баз данных часто включает разделение больших текстов на более мелкие фрагменты, или chunks. Это необходимо для эффективного индексирования и поиска, но порождает фундаментальную проблему: каждый отдельный chunk, вырванный из своего первоначального окружения, теряет связь с более широким контекстом исходного документа. Представьте себе объемный отчет, разбитый на сотни мелких абзацев. Когда система RAG извлекает один такой chunk в ответ на запрос, этот фрагмент может содержать важную информацию, но без понимания, откуда он взят в документе, к чему относится или какие другие разделы его дополняют, его ценность для LLM может быть значительно снижена. Это приводит к менее точным или неполным ответам, поскольку модель не получает полной картины. Именно эту проблему призван решить контекстный поиск (Contextual Retrieval). Контекстный поиск — это передовая техника, разработанная для повышения точности RAG-систем путем обогащения отдельных chunks дополнительной информацией об их положении и значении в исходном документе. Вместо того чтобы просто индексировать изолированные фрагменты текста, эта методика добавляет к каждому chunk краткое описание, которое "ситуационирует" его в более широком контексте. Основная идея заключается в том, чтобы перед добавлением chunks в поисковую базу данных (будь то векторная база данных или индекс BM25) использовать мощь LLM, такой как Claude, для генерации этого дополнительного контекста. Таким образом, когда система RAG извлекает chunk, она получает не просто фрагмент текста, а "контекстуализированный chunk", который содержит как сам текст, так и метаданные, описывающие его место и значение в исходном документе. Это значительно улучшает понимание извлеченной информации и, как следствие, качество генерируемых ответов. Процесс реализации контекстного поиска включает несколько ключевых шагов, которые выполняются до того, как chunks будут проиндексированы в вашей поисковой системе.
План урока
- Введение: Преодоление проблемы потери контекста в RAG-системах
- Что такое контекстный поиск (Contextual Retrieval)?
- Как работает контекстный поиск: Пошаговое руководство
- Работа с большими документами: Ограничения контекстного окна Claude
- Пример реализации: Обогащение фрагментов с помощью Claude
- Когда использовать контекстный поиск? Преимущества и компромиссы
- Заключение
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.