О чём урок
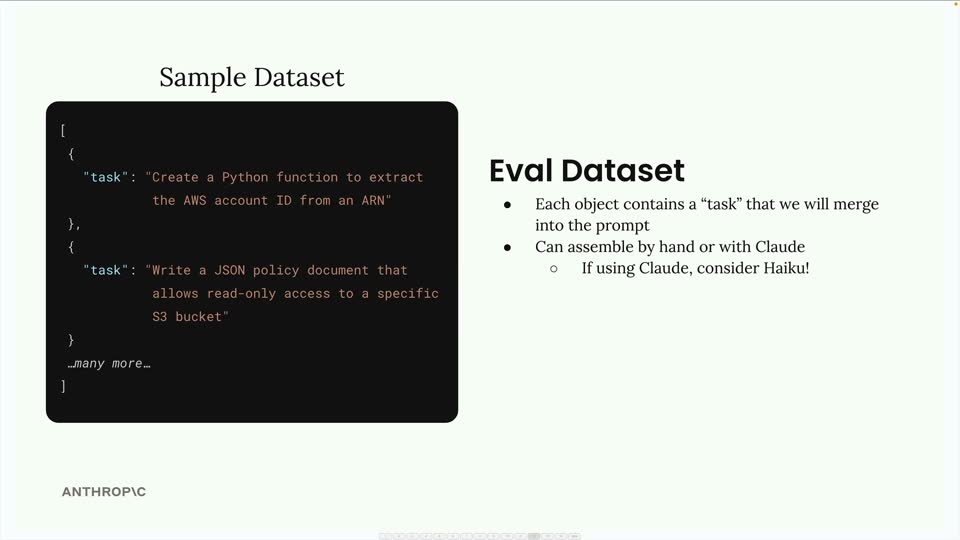
Разработка эффективных подсказок (prompts) для больших языковых моделей (LLM), таких как Claude, — это и искусство, и наука. Чтобы убедиться, что ваша подсказка работает так, как задумано, и стабильно выдает высококачественные результаты, необходимо систематически ее оценивать. Первый шаг в этом процессе — создание надежной подсказки, а затем — генерация репрезентативных тестовых данных, чтобы проверить ее производительность в различных сценариях. В этом уроке мы рассмотрим, как настроить систему для генерации таких тестовых данных, используя самого Claude. Представьте, что мы разрабатываем подсказку для Claude, которая должна помогать пользователям писать код, специфичный для Amazon Web Services (AWS). Наша подсказка должна уметь генерировать три конкретных типа вывода для различных сценариев использования AWS: Файлы конфигурации в формате JSON. Регулярные выражения (Regex). Код на Python. Ключевое требование к этой подсказке заключается в том, что при запросе помощи по определенной задаче Claude должен возвращать чистый вывод в одном из этих форматов, без каких-либо дополнительных объяснений, заголовков или подвалов. Например, если пользователь просит JSON-конфигурацию для S3-бакета, Claude должен вернуть только сам JSON-объект. Вот как может выглядеть наша отправная точка для такой подсказки (версия 1): prompt = f"""Пожалуйста, предоставьте решение для следующей задачи:{task}""" Здесь {task} — это переменная, куда будет подставляться конкретная задача пользователя. Набор данных для оценки (evaluation dataset) — это коллекция входных данных, которые мы будем подавать в нашу основную подсказку. Для каждой комбинации подсказки и входных данных мы будем запускать подсказку и анализировать полученные результаты. Это позволяет нам проверить, насколько хорошо подсказка справляется с разнообразными запросами и соответствует нашим требованиям к формату и содержанию. Наш набор данных будет представлять собой массив объектов JSON, где каждый объект содержит свойство "task", описывающее, что мы хотим, чтобы Claude выполнил. Существует два основных способа создания такого набора данных: Вручную: Мы можем самостоятельно придумать и записать каждую задачу. Это может быть трудоемко и не всегда охватывает все возможные сценарии.
План урока
- Генерация тестовых наборов данных для оценки подсказок Claude
- Цель нашей подсказки: генерация AWS-специфичного кода
- Создание набора данных для оценки
- Автоматическая генерация тестовых данных с помощью Claude
- Надежный парсинг JSON с помощью префиллинга и стоп-последовательностей
- Пример генерации набора данных
- Сохранение набора данных
- Заключение
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.