О чём урок
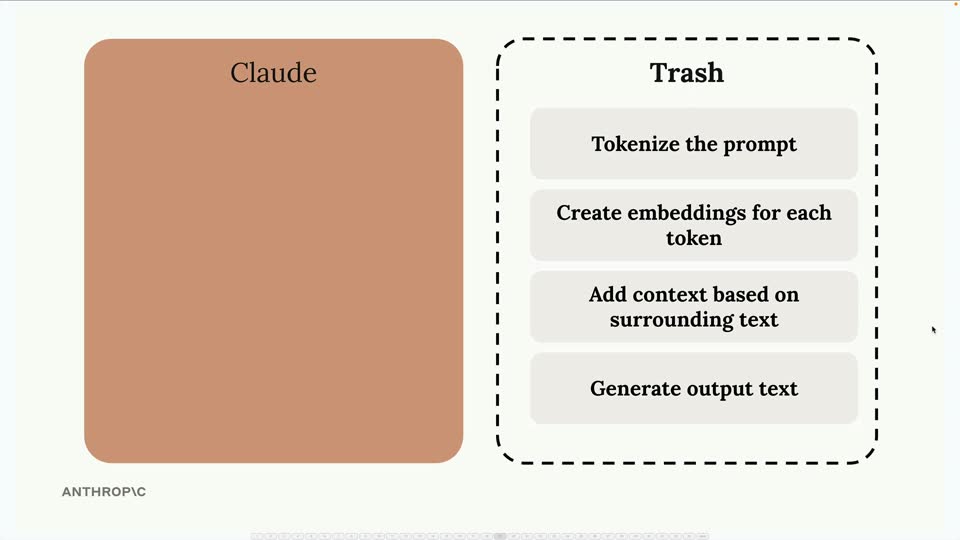
Кэширование промптов — это интеллектуальная функция, разработанная для значительного ускорения ответов Claude и снижения стоимости генерации текста. Она достигается за счет повторного использования вычислительной работы, выполненной в предыдущих запросах. Вместо того чтобы каждый раз выполнять всю работу с нуля, Claude может сохранять и повторно использовать результаты предварительной обработки, когда вы отправляете похожий контент. Представьте, что Claude запоминает часть своей работы, чтобы не делать ее снова и снова, что делает взаимодействие с моделью более эффективным и экономичным. Чтобы по-настоящему оценить преимущества кэширования промптов, давайте сначала разберемся, что происходит во время обычного запроса к Claude, когда кэширование не используется. Когда вы отправляете сообщение Claude, он не сразу начинает генерировать ответ. Прежде чем приступить к созданию текста, Claude выполняет огромный объем предварительной обработки вашего ввода. Этот процесс включает несколько ключевых этапов: Токенизация (Tokenization): Сначала Claude разбивает ваш промпт на более мелкие, управляемые части, называемые токенами. Это могут быть слова, части слов, знаки препинания или даже пробелы. Например, фраза "Привет, мир!" может быть разбита на токены ["Привет", ",", "мир", "!"]. Этот шаг позволяет модели работать с текстом на более гранулярном уровне. Создание эмбеддингов (Embeddings): Для каждого токена Claude создает числовое представление, или эмбеддинг. Эти эмбеддинги — это многомерные векторы, которые кодируют семантическое значение токена и его отношения с другими токенами в контексте. Это позволяет Claude "понимать" смысл слов и их контекст, а не просто рассматривать их как отдельные символы. Добавление контекста: На основе окружающего текста и предыдущих сообщений (если это диалог), Claude формирует глубокое понимание контекста всего запроса. Это критически важно для генерации связных, релевантных и логически последовательных ответов. Генерация текста: Только после выполнения всей этой подготовительной работы Claude приступает к фактической генерации выходного текста, основываясь на полученном понимании и своей языковой модели (LLM). После того как Claude отправляет вам ответ, вся эта вычислительная работа — токенизация, создание эмбеддингов и анализ контекста — обычно отбрасывается.
План урока
- Кэширование промптов (Prompt Caching)
- Как Claude обрабатывает запросы без кэширования
- Проблема повторной обработки данных
- Как кэширование промптов решает эту проблему
- Ключевые преимущества кэширования промптов
- Важные ограничения и сценарии использования
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.