Введение в Argilla[[introduction-to-argilla]]
В Главе 5 вы узнали, как создавать датасеты с использованием библиотеки 🤗 Datasets, а в Главе 6 — как fine-tune модели для некоторых распространённых NLP-задач. В этой главе вы узнаете, как использовать Argilla для аннотирования и курирования датасетов, которые можно применять для обучения и оценки ваших моделей.
Ключ к обучению моделей, демонстрирующих высокую производительность, — это наличие высококачественных данных. Хотя в Hub есть хорошие датасеты, которые можно использовать для обучения и оценки ваших моделей, они могут быть нерелевантны для вашего конкретного приложения или сценария использования. В таком случае вы, возможно, захотите создать и курировать собственный датасет. Argilla поможет вам сделать это эффективно.
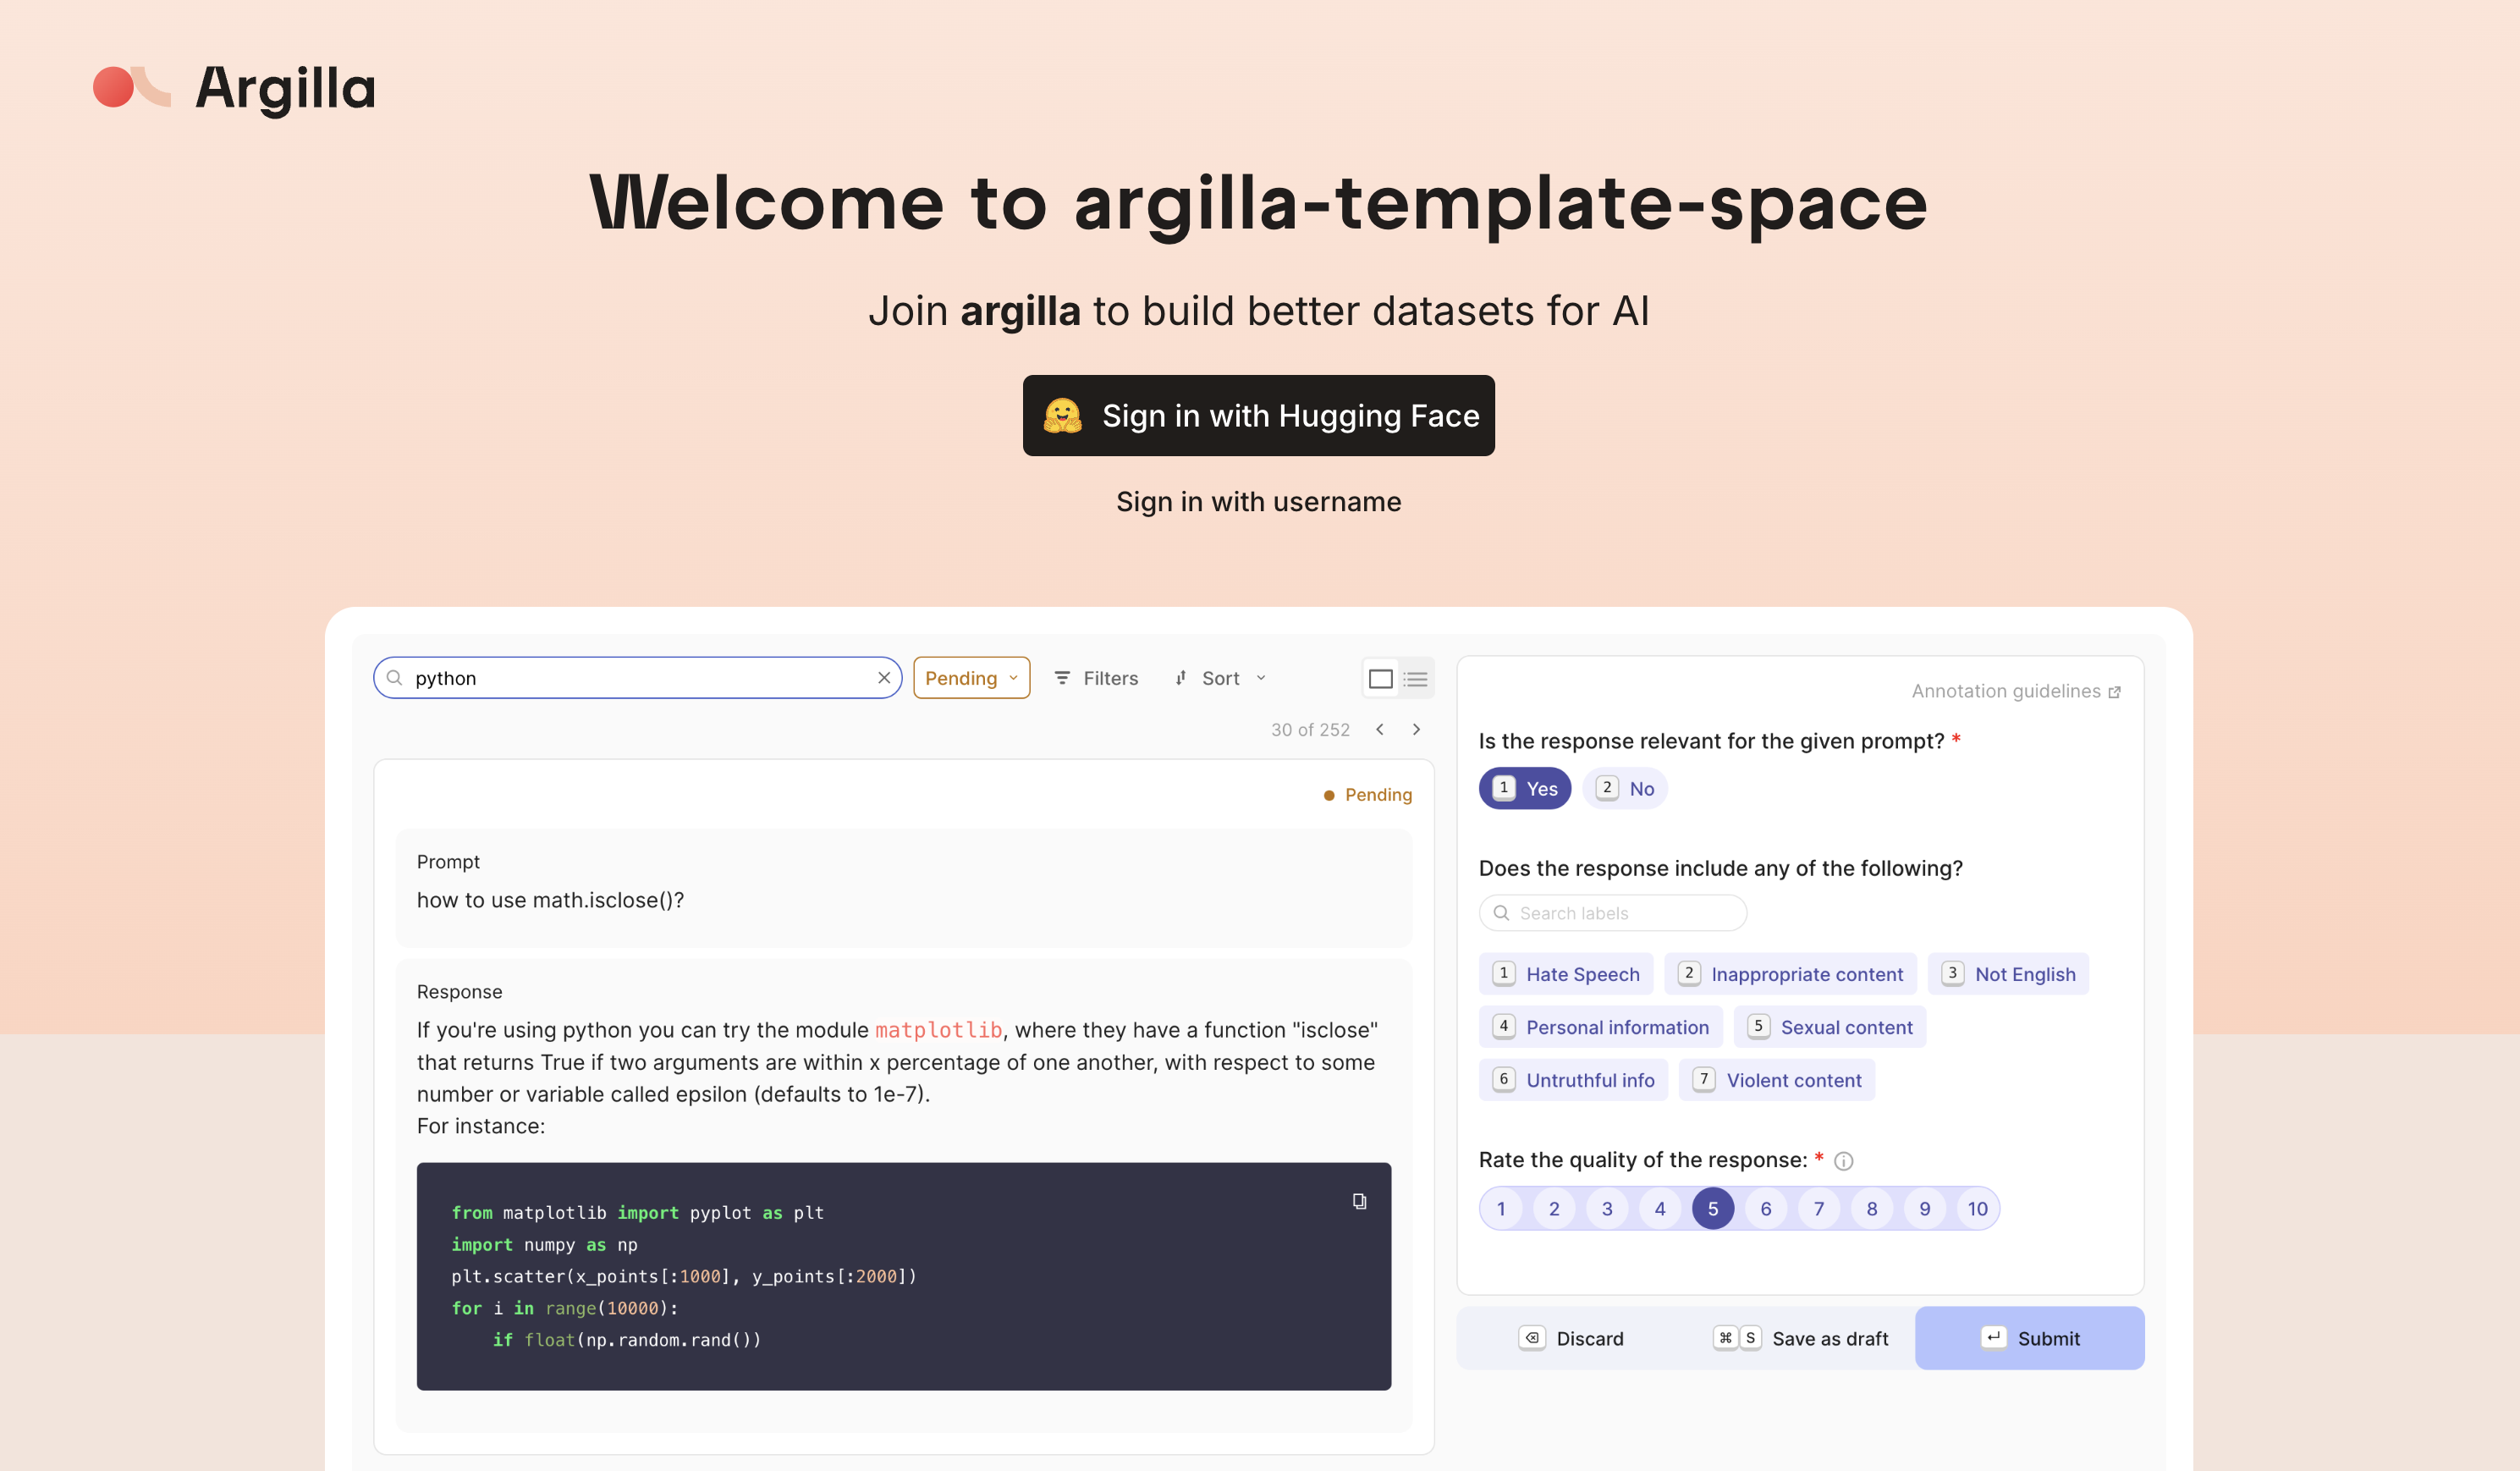
С помощью Argilla вы можете:
- превращать неструктурированные данные в структурированные данные для использования в NLP-задачах.
- курировать датасет, чтобы перейти от низкокачественного датасета к высококачественному датасету.
- собирать обратную связь от людей для LLM и мультимодальных моделей.
- приглашать экспертов для совместной работы в Argilla или использовать краудсорсинг для аннотаций!
Вот некоторые из тем, которые вы изучите в этой главе:
- Как настроить собственный инстанс Argilla.
- Как загрузить датасет и настроить его на основе популярных NLP-задач.
- Как использовать UI Argilla для аннотирования вашего датасета.
- Как использовать ваш курированный датасет и экспортировать его в Hub.