Исследование и сравнение различных LLM
Примечание AI University. Примеры кода в оригинале курса рассчитаны на Azure OpenAI или GitHub Models. Те же запросы можно отправлять через OpenAI API или другой OpenAI-совместимый сервис: замените клиент, адрес сервиса, название модели и ключ на свои и сверьтесь с документацией выбранного провайдера.
Нажмите на изображение выше, чтобы посмотреть видео этого урока
В предыдущем уроке мы увидели, как генеративный ИИ меняет технологический ландшафт, как работают большие языковые модели (LLM) и как бизнес, например наш стартап, может применять их для своих задач и развиваться! В этой главе мы сравним различные типы больших языковых моделей (LLM), чтобы понять их достоинства и недостатки.
Следующий шаг в развитии нашего стартапа: изучить текущий ландшафт LLM и понять, какие из них подходят для нашего варианта использования.
Введение
В этом уроке:
- Вы узнаете о различных типах LLM в текущем ландшафте.
- Мы рассмотрим тестирование, итерации и сравнение различных моделей для вашего варианта использования в Azure.
- Вы узнаете, как развернуть LLM.
Цели обучения
После завершения этого урока вы сможете:
- Выбирать подходящую модель для вашего варианта использования.
- Понимать, как тестировать, выполнять итерации и улучшать производительность вашей модели.
- Знать, как компании развертывают модели.
Различные типы больших языковых моделей (LLM)
Большие языковые модели (LLM) можно классифицировать по архитектуре, обучающим данным и сценариям использования. Понимание этих различий поможет вашей компании выбрать подходящую модель, а также тестировать, улучшать и повышать её производительность.
Существует множество типов LLM-моделей. Ваш выбор зависит от целей использования, имеющихся данных, готовности платить и других факторов.
В зависимости от того, планируете ли вы использовать модели для генерации текста, аудио, видео, изображений и так далее, вы можете выбрать модель определённого типа.
Распознавание аудио и речи. Модели семейства Whisper по-прежнему остаются полезными универсальными моделями распознавания речи. Однако в производственных системах теперь также используются новые модели преобразования речи в текст, такие как
gpt-4o-transcribe,gpt-4o-mini-transcribe, а также варианты с диаризацией. Оцените покрытие языков, возможности диаризации, поддержку в реальном времени, задержку и стоимость для вашего сценария. Подробнее читайте в документации OpenAI по преобразованию речи в текст.Генерация изображений. DALL-E и Midjourney хорошо известны как инструменты для генерации изображений. Однако текущие API OpenAI для работы с изображениями сосредоточены на моделях GPT Image, таких как
gpt-image-2. Также распространены семейства моделей Stable Diffusion, Imagen, Flux и другие. Сравните точность следования промпту, поддержку редактирования, контроль стиля, требования к безопасности и лицензирование. Подробнее читайте в руководстве OpenAI по генерации изображений и в главе 9 этого курса.Генерация текста. Текстовые модели теперь включают передовые модели, модели для рассуждений, компактные модели с низкой задержкой и модели с открытыми весами. Примеры: модели OpenAI GPT-5.x, Anthropic Claude 4.x, Google Gemini 3.x, Meta Llama 4 и Mistral. Не выбирайте модель только по дате выпуска или цене. Сравнивайте качество выполнения задач, задержку, размер контекстного окна, возможности использования инструментов, поведение в отношении безопасности, региональную доступность и общую стоимость. Каталог моделей Microsoft Foundry является хорошим ресурсом для сравнения моделей, доступных в Azure.
Мультимодальность. Многие современные модели могут обрабатывать не только текст. Некоторые принимают изображения, аудио или видео в качестве входных данных; некоторые могут вызывать инструменты; а специализированные модели могут генерировать изображения, аудио или видео. Например, современные модели OpenAI поддерживают ввод текста и изображений, модели Gemini могут поддерживать ввод текста, кода, изображений, аудио и видео в зависимости от варианта, а Llama 4 Scout и Maverick представляют собой нативно мультимодальные модели с открытыми весами. Всегда проверяйте карточку каждой модели на предмет поддерживаемых входных и выходных модальностей, прежде чем строить на её основе рабочий процесс.
Выбор модели даёт вам определённые базовые возможности, которых, однако, может быть недостаточно. Часто у вас есть специфичные для компании данные, о которых нужно каким-то образом сообщить LLM. Существует несколько подходов к решению этой задачи, подробнее о них вы узнаете в следующих разделах.
Фундаментальные модели и LLM
Термин «фундаментальная модель» был введён исследователями Стэнфорда и определён как модель ИИ, которая соответствует следующим критериям:
- Обучаются с использованием неконтролируемого или самоконтролируемого обучения, то есть на неразмеченных мультимодальных данных, и не требуют ручной аннотации или разметки данных для процесса обучения.
- Представляют собой очень большие модели, основанные на глубоких нейронных сетях, обученных на миллиардах параметров.
- Обычно предназначены служить «фундаментом» для других моделей, то есть могут использоваться в качестве отправной точки для создания других моделей путём дообучения (fine-tuning).
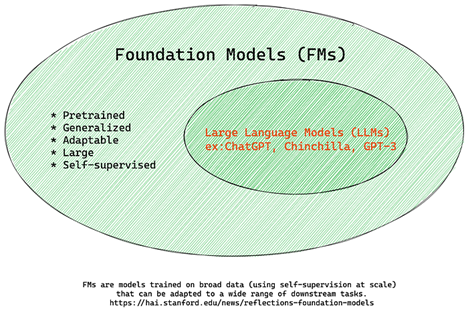
Источник изображения: Essential Guide to Foundation Models and Large Language Models | by Babar M Bhatti | Medium
Чтобы ещё больше прояснить это различие, рассмотрим ChatGPT как исторический пример. Ранние версии ChatGPT использовали GPT-3.5 в качестве фундаментальной модели. Затем OpenAI применил данные, специфичные для чатов, и методы выравнивания, чтобы создать дообученную версию, которая лучше работала в разговорных сценариях, таких как чат-боты. Современные сервисы ИИ часто переключаются между несколькими вариантами моделей, поэтому название сервиса и название базовой модели не всегда совпадают.
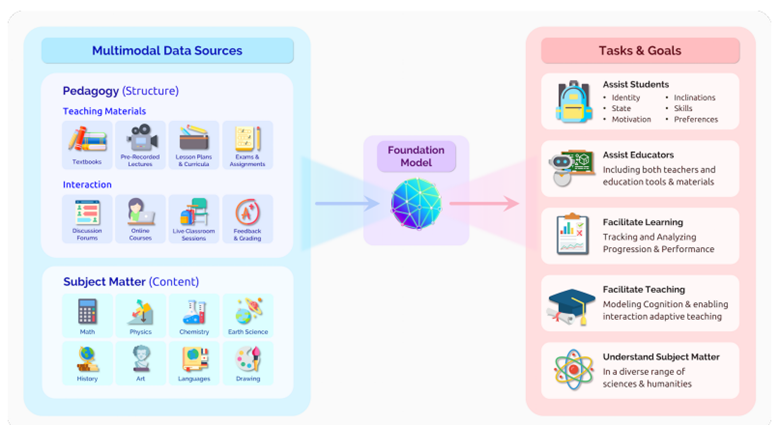
Источник изображения: 2108.07258.pdf (arxiv.org)
Модели с открытыми весами/открытым исходным кодом и проприетарные модели
Ещё один способ классификации LLM: по доступности весов и лицензированию. Модели могут быть с открытыми весами, с открытым исходным кодом или проприетарными.
Модели с открытым исходным кодом и открытыми весами предоставляют артефакты модели для проверки, загрузки или настройки, но их лицензии различаются. Некоторые являются полностью открытым исходным кодом, в то время как другие представляют собой модели с открытыми весами, но с ограничениями на использование. Они могут быть полезны, когда бизнесу требуется больший контроль над развёртыванием, локализацией данных, стоимостью или кастомизацией. Однако командам всё равно необходимо изучить условия лицензии, затраты на обслуживание, поддержку, обновления безопасности и качество оценки, прежде чем использовать их в продакшене. Примеры: Meta Llama 4, некоторые модели Mistral и многие модели, размещённые на Hugging Face.
Проприетарные модели принадлежат и размещаются провайдером. Эти модели часто оптимизированы для управляемого использования в продакшене и могут предлагать надёжную поддержку, системы безопасности, интеграцию инструментов и масштабирование. Однако клиенты обычно не могут проверять или изменять веса модели, и им необходимо изучить условия провайдера в отношении конфиденциальности, хранения данных, соответствия требованиям и допустимого использования. Примеры: модели OpenAI, Google Gemini и Anthropic Claude.
Эмбеддинги, генерация изображений, генерация текста и кода
LLM также можно классифицировать по типу генерируемого вывода.
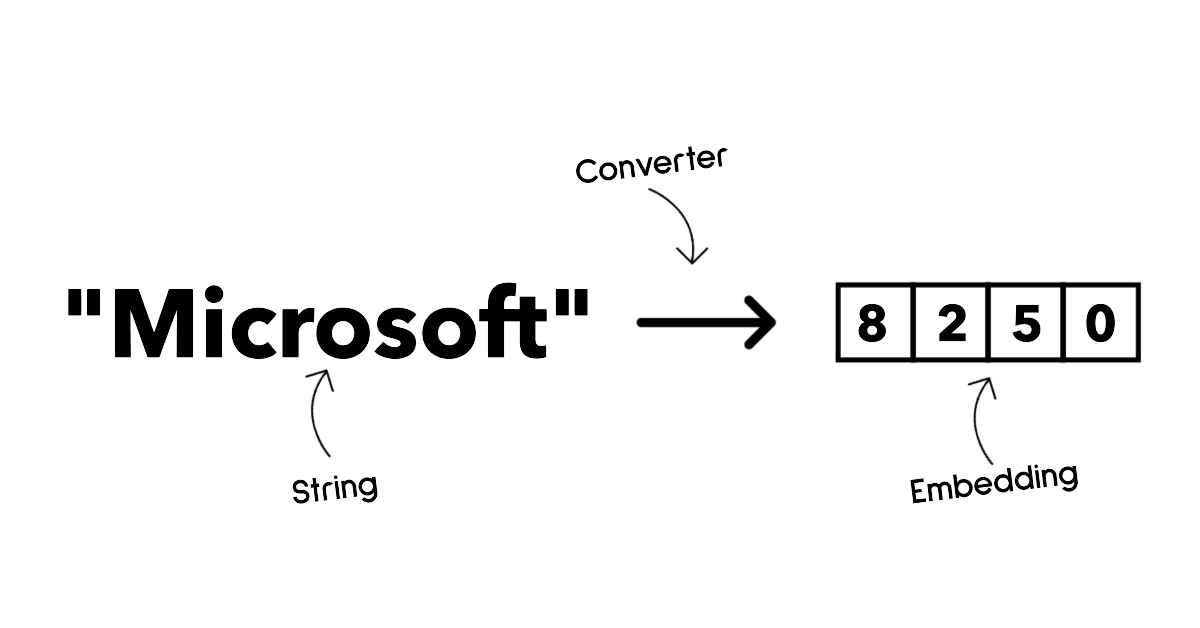
Эмбеддинги представляют собой набор моделей, которые могут преобразовывать текст в числовую форму, называемую эмбеддингом (векторным представлением). Эмбеддинги облегчают машинам понимание взаимосвязей между словами или предложениями и могут использоваться в качестве входных данных другими моделями, такими как классификационные или кластерные модели, которые демонстрируют лучшую производительность на числовых данных. Модели эмбеддингов часто используются для трансферного обучения, когда модель создаётся для вспомогательной задачи, для которой имеется большое количество данных, а затем веса модели (эмбеддинги) повторно используются для других последующих задач. Примером этой категории являются эмбеддинги OpenAI.
Модели генерации изображений: это модели, которые генерируют изображения. Эти модели часто используются для редактирования, синтеза и преобразования изображений. Модели генерации изображений обычно обучаются на больших наборах данных изображений, таких как LAION-5B, и могут использоваться для создания новых изображений или для редактирования существующих изображений с помощью техник инпейнтинга, суперразрешения и колоризации. Примеры: модели GPT Image, модели Stable Diffusion и модели Imagen.
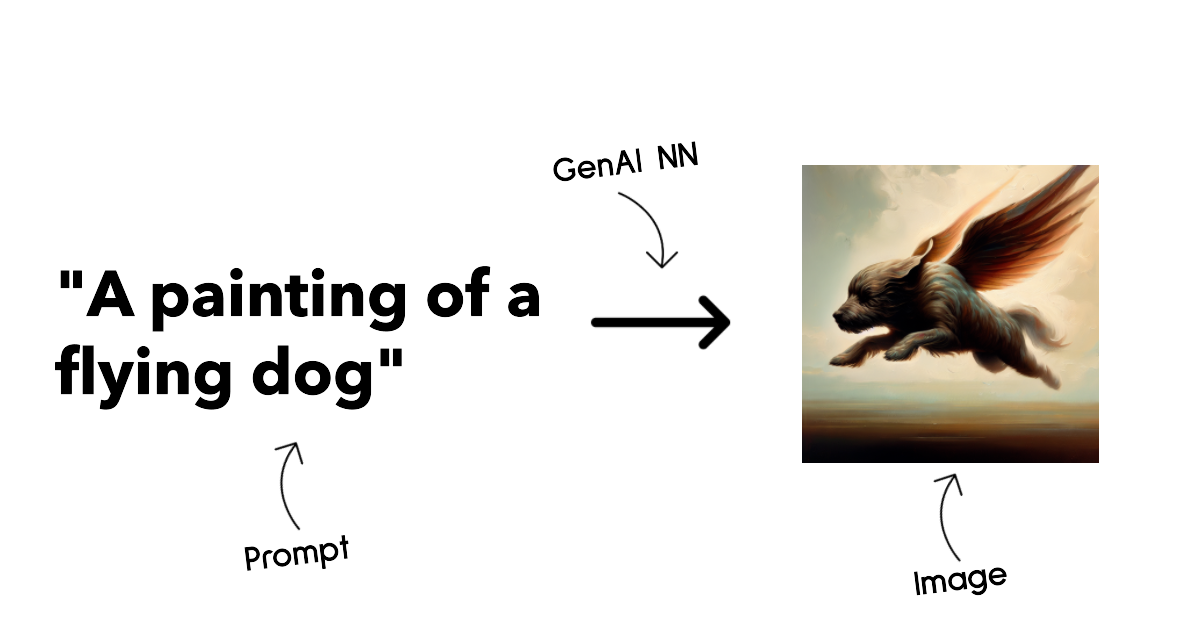
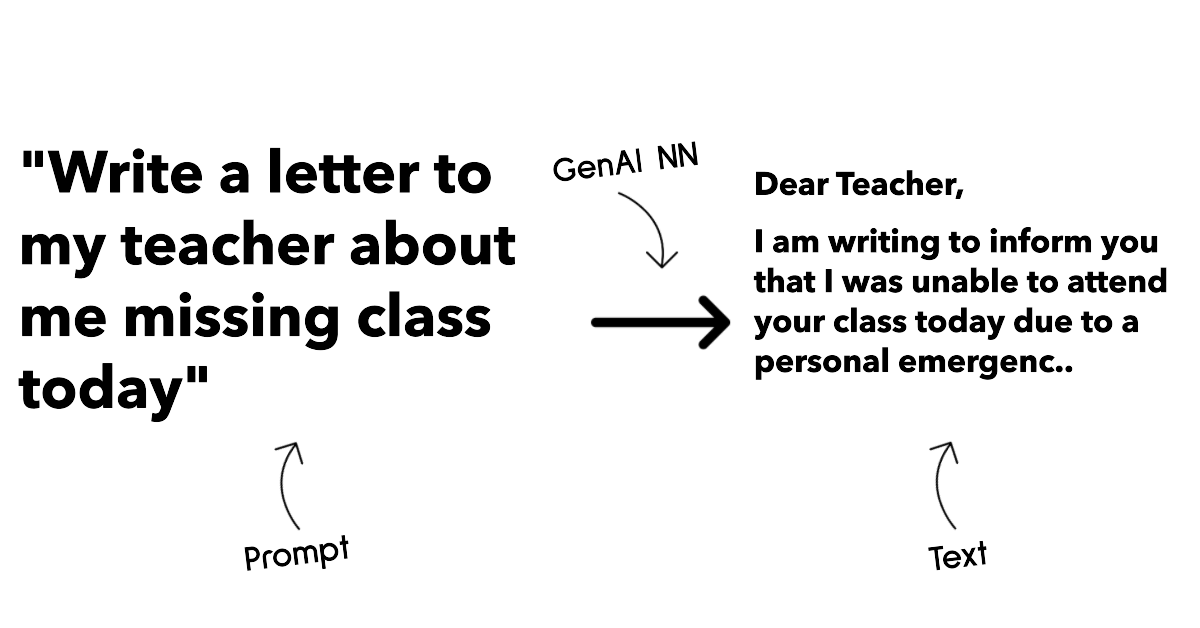
Модели генерации текста и кода: это модели, которые генерируют текст или код. Эти модели часто используются для суммаризации текста, перевода и ответов на вопросы. Модели генерации текста обычно обучаются на больших наборах текстовых данных, таких как BookCorpus, и могут использоваться для создания нового текста или для ответов на вопросы. Модели генерации кода, такие как CodeParrot, часто обучаются на больших наборах данных кода, таких как GitHub, и могут использоваться для создания нового кода или для исправления ошибок в существующем коде.
Энкодер-декодер и только декодер
Чтобы обсудить различные типы архитектур LLM, давайте воспользуемся аналогией.
Представьте, что ваш руководитель поручил вам составить викторину для студентов. У вас есть два коллеги: один отвечает за создание контента, а другой, за его проверку.
Создатель контента похож на модель типа «только декодер»: он может посмотреть на тему, увидеть, что вы уже написали, а затем продолжить генерировать контент на основе этого контекста. Такие модели очень хорошо справляются с написанием увлекательного и информативного контента, но не всегда являются лучшим выбором, когда задача состоит только в классификации, извлечении или кодировании информации. Примеры семейств моделей типа «только декодер»: GPT и Llama.
Проверяющий похож на модель типа «только энкодер»: он просматривает написанный курс и ответы, замечая взаимосвязи между ними и понимая контекст, но он плохо справляется с генерацией контента. Примером модели типа «только энкодер» является BERT.
Представьте, что у нас есть кто-то, кто может и создавать, и проверять викторину. Это модель типа «энкодер-декодер». Примеры: BART и T5.
Сервис и модель
Теперь давайте поговорим о различии между сервисом и моделью. Сервис представляет собой продукт, предлагаемый поставщиком облачных услуг, и часто является комбинацией моделей, данных и других компонентов. Модель является основным компонентом сервиса и часто представляет собой фундаментальную модель, такую как LLM.
Сервисы часто оптимизированы для использования в продакшене и, как правило, проще в использовании, например, через графический пользовательский интерфейс. Однако сервисы не всегда доступны бесплатно и могут требовать подписки или оплаты за использование в обмен на использование оборудования и ресурсов владельца сервиса, оптимизацию расходов и лёгкое масштабирование. Примером сервиса является Azure OpenAI Service, который предлагает тарифный план с оплатой по факту использования, что означает, что пользователи оплачивают пропорционально объёму использования сервиса. Azure OpenAI Service также предлагает корпоративный уровень безопасности и систему ответственного ИИ в дополнение к возможностям моделей.
Модели представляют собой артефакты нейронной сети: параметры, веса, архитектуру, токенизатор и вспомогательную конфигурацию. Запуск модели локально или в частной среде требует подходящего оборудования, инфраструктуры для обслуживания, мониторинга и либо совместимой лицензии с открытым исходным кодом/открытыми весами, либо коммерческой лицензии. Модели с открытыми весами, такие как Llama 4 или Mistral, могут быть размещены самостоятельно, но для этого всё равно требуются вычислительные мощности и операционная экспертиза.
Как тестировать и итеративно улучшать модели на Azure для оценки производительности
После того как ваша команда изучит текущий ландшафт больших языковых моделей (LLM) и выберет подходящие кандидаты для своих сценариев, следующим шагом будет тестирование этих моделей на ваших данных и в вашей рабочей нагрузке. Это итеративный процесс, который включает эксперименты и измерения. Большинство моделей, упомянутых ранее (модели OpenAI, открытые модели, такие как Llama 4 и Mistral, а также модели Hugging Face), доступны в Microsoft Foundry Models.
Microsoft Foundry, ранее известная как Azure AI Studio/Azure AI Foundry, представляет собой унифицированную платформу Azure для создания ИИ-приложений и агентов. Она помогает разработчикам управлять жизненным циклом от экспериментов и оценки до развёртывания, мониторинга и управления. Каталог моделей в Microsoft Foundry позволяет пользователю:
- Найти интересующую базовую модель в каталоге, включая модели, предлагаемые Azure, а также модели от партнёров и сообщества. Вы можете фильтровать по задаче, поставщику, лицензии, варианту развёртывания или названию.
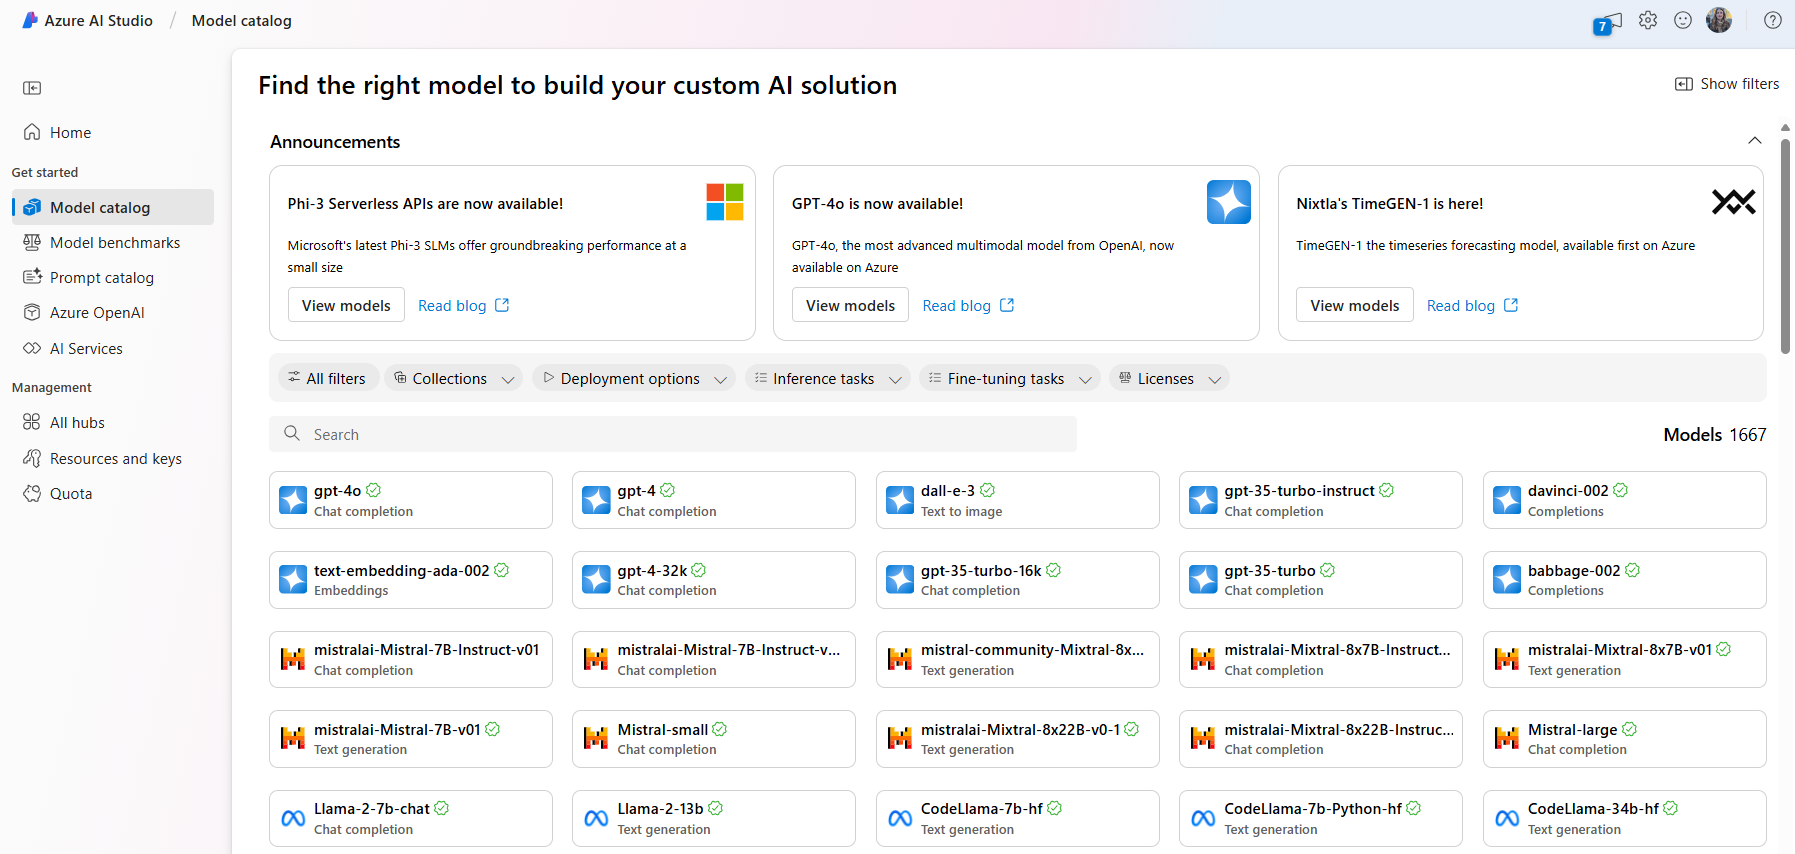
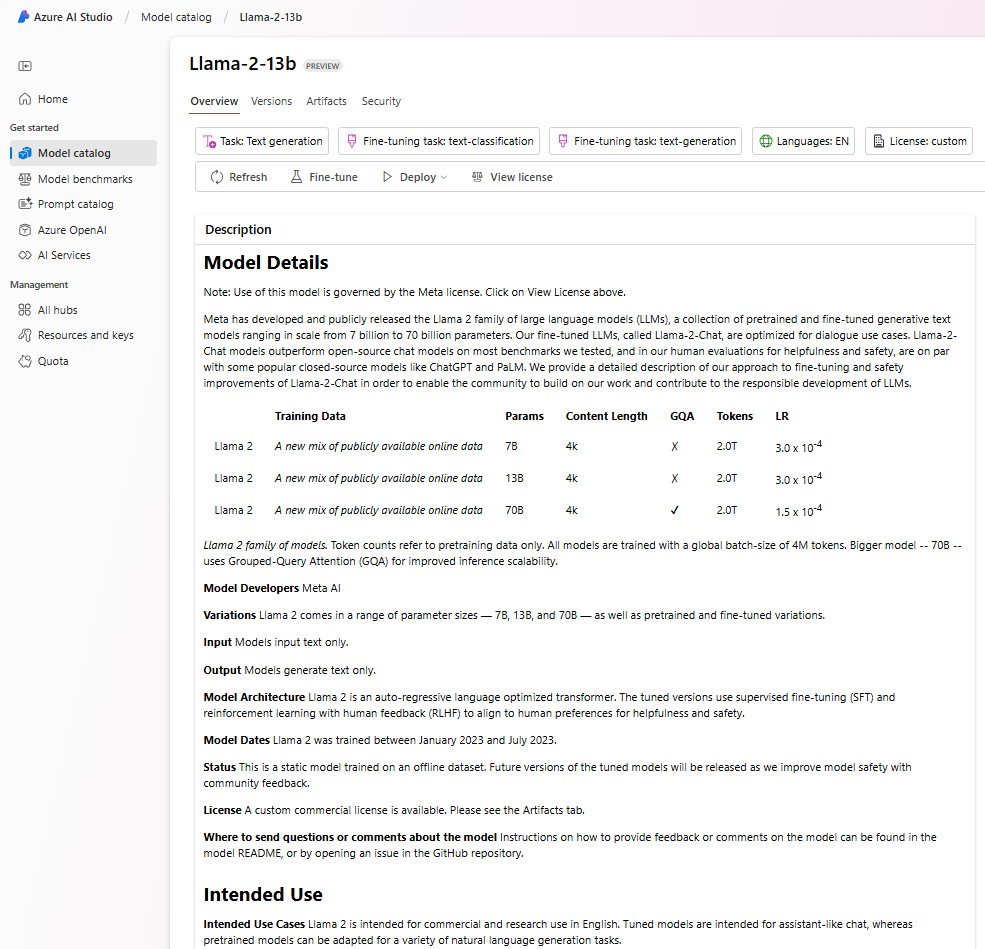
- Просмотреть карточку модели, которая содержит подробное описание предполагаемого использования и данных для обучения, примеры кода и результаты оценки во внутренней библиотеке оценок.
- Сравнить бенчмарки различных моделей и наборов данных, доступных в отрасли, чтобы определить, какая из них соответствует вашему бизнес-сценарию, используя панель Model Benchmarks.
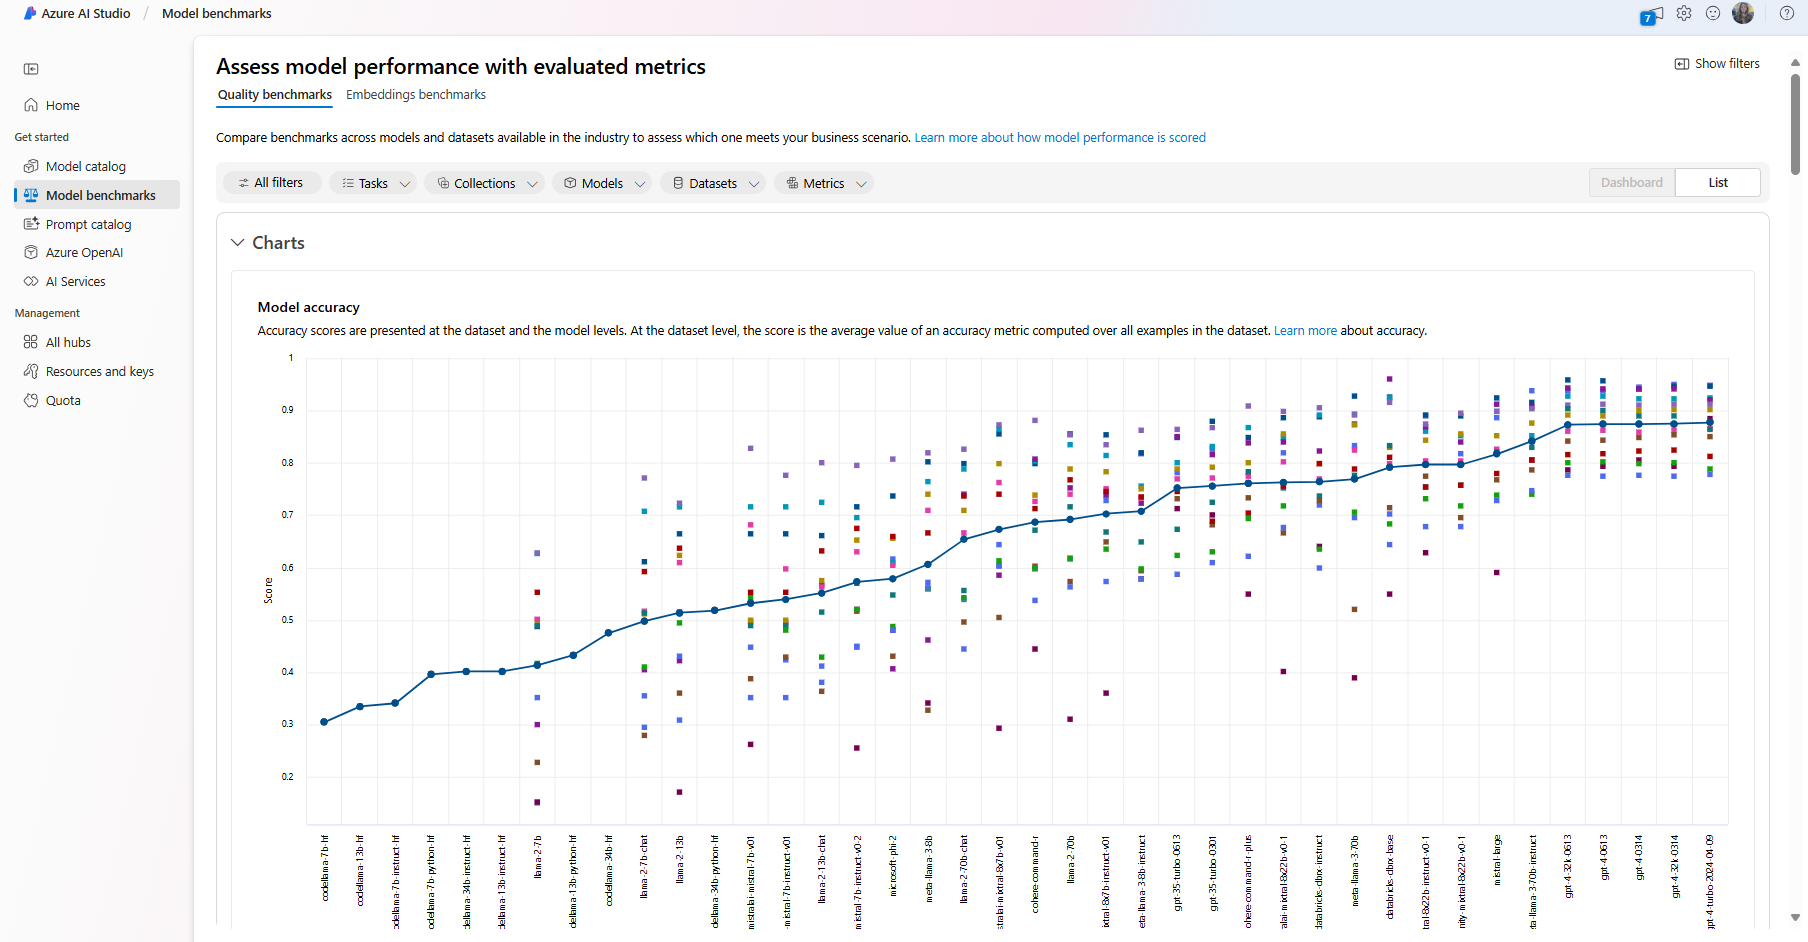
- Дообучать (fine-tuning) поддерживаемые модели на пользовательских данных для обучения, чтобы улучшить производительность модели в конкретной рабочей нагрузке, используя возможности экспериментов и отслеживания Microsoft Foundry.
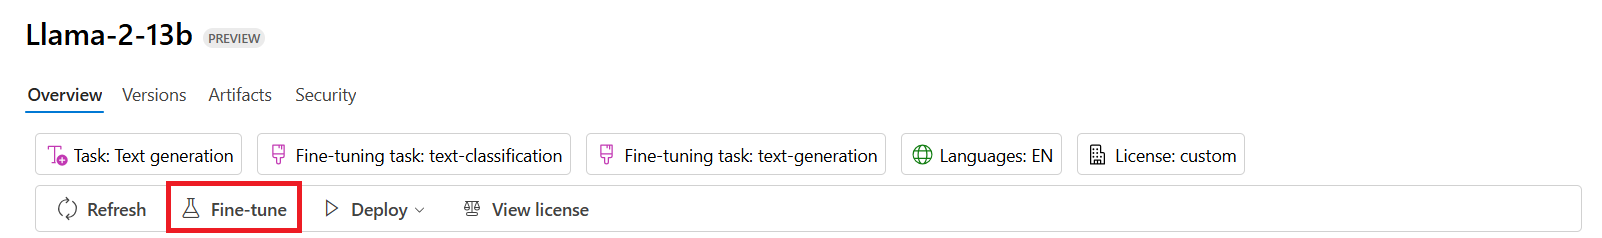
- Развёртывать исходную предобученную модель или дообученную версию на удалённую конечную точку вывода в реальном времени, используя управляемые вычисления или бессерверные варианты развёртывания, чтобы приложения могли её использовать.
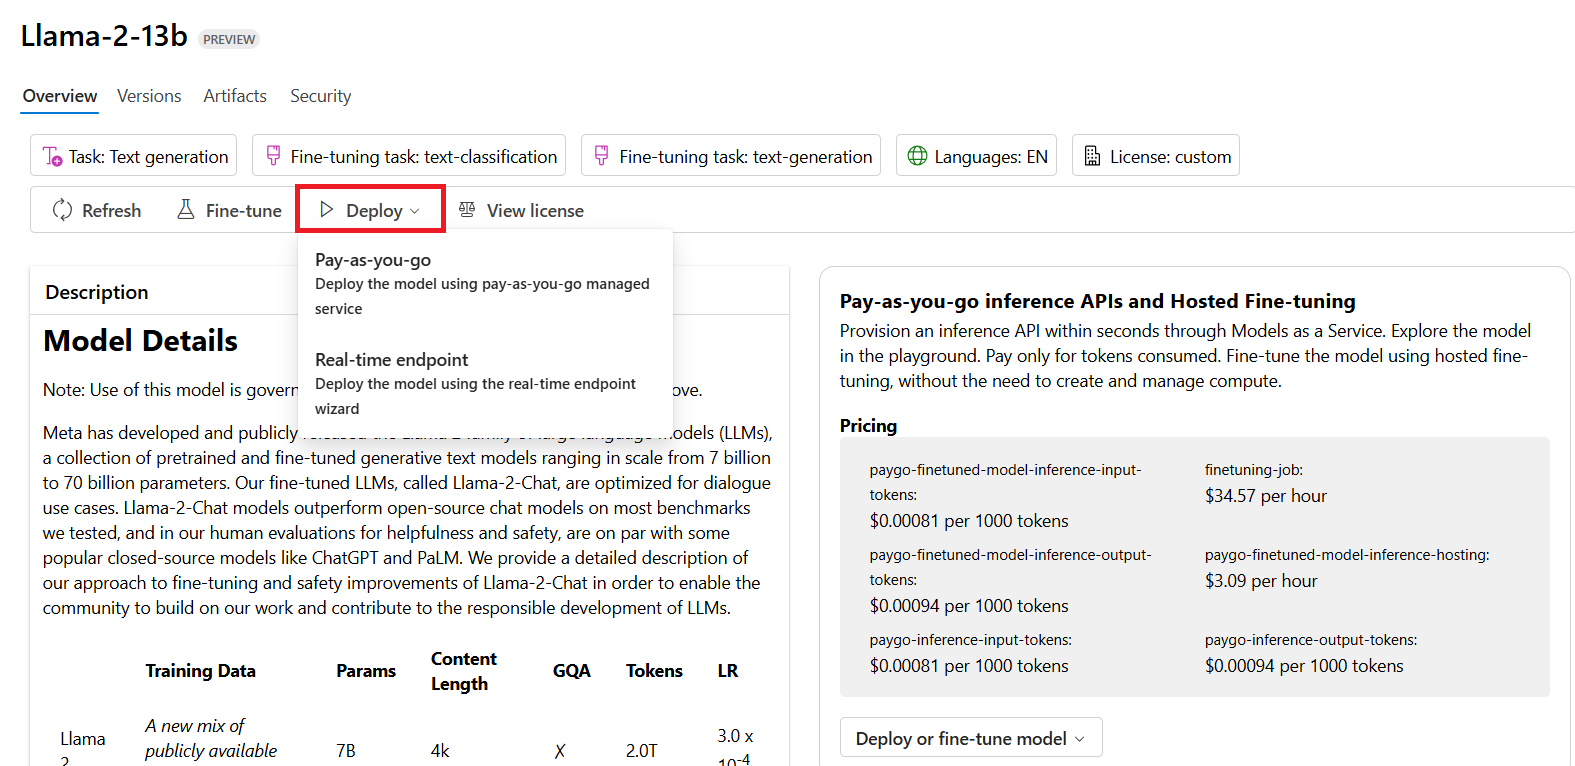
[!NOTE] Не все модели в каталоге в настоящее время доступны для дообучения (fine-tuning) и/или развёртывания с оплатой по мере использования. Подробную информацию о возможностях и ограничениях модели можно найти в её карточке.
Улучшение результатов LLM
Мы с нашей командой стартапа изучили различные виды LLM и облачную платформу (Microsoft Foundry), которая позволяет сравнивать разные модели, оценивать их на тестовых данных, улучшать производительность и развёртывать на конечных точках вывода.
Но когда следует рассматривать дообучение (fine-tuning) модели вместо использования предобученной? Существуют ли другие подходы для улучшения производительности модели в конкретных рабочих нагрузках?
Существует несколько подходов, которые компания может использовать для получения необходимых результатов от LLM. Вы можете выбирать разные типы моделей с разной степенью обучения при развёртывании LLM в продакшене, с разными уровнями сложности, стоимости и качества. Вот некоторые из этих подходов:
Промпт-инжиниринг с контекстом. Идея заключается в том, чтобы предоставить достаточно контекста при составлении промпта, чтобы получить нужные ответы.
Retrieval Augmented Generation (RAG). Ваши данные могут храниться, например, в базе данных или веб-конечной точке. Чтобы эти данные или их подмножество были включены во время промпта, вы можете извлечь релевантные данные и сделать их частью промпта пользователя.
Дообученная (fine-tuned) модель. В этом случае вы дополнительно обучаете модель на своих данных, что делает её более точной и отзывчивой к вашим потребностям, но это может быть дорогостоящим.
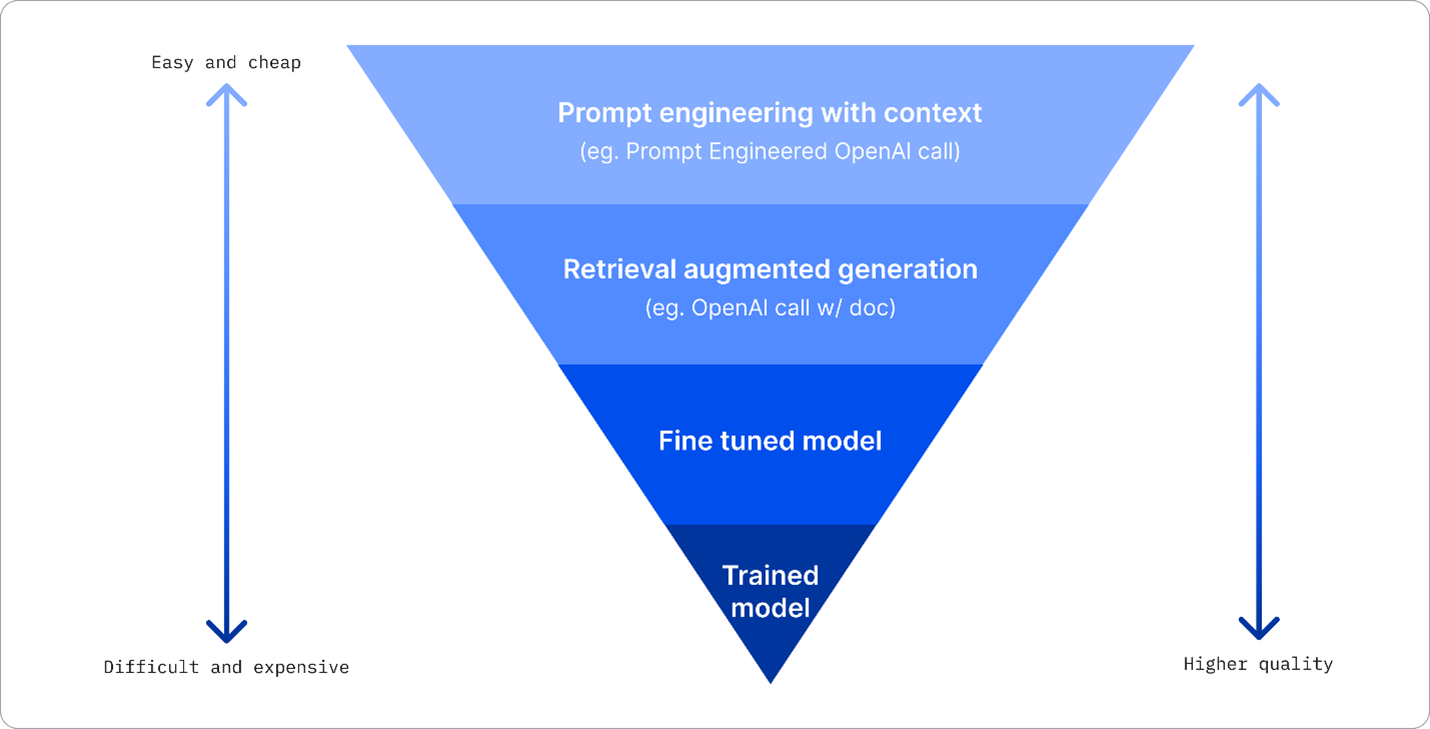
Источник изображения: Four Ways that Enterprises Deploy LLMs | Fiddler AI Blog
Промпт-инжиниринг с контекстом
Предобученные LLM очень хорошо справляются с обобщёнными задачами обработки естественного языка, даже при вызове с коротким промптом, например, предложением для завершения или вопросом, это так называемое «обучение с нулевым примером» (zero-shot learning).
Однако чем точнее пользователь может сформулировать свой запрос, предоставив подробное описание и примеры (контекст), тем более точным и соответствующим ожиданиям пользователя будет ответ. В этом случае говорят об «обучении с одним примером» (one-shot learning), если промпт включает только один пример, и об «обучении с несколькими примерами» (few-shot learning), если он включает несколько примеров. Промпт-инжиниринг с контекстом является наиболее экономически эффективным подходом для начала работы.
Retrieval Augmented Generation (RAG)
LLM имеют ограничение: они могут использовать только те данные, которые были задействованы во время их обучения для генерации ответа. Это означает, что они ничего не знают о фактах, произошедших после их обучения, и не могут получить доступ к непубличной информации (например, данным компании). Это можно преодолеть с помощью RAG, техники, которая дополняет промпт внешними данными в виде фрагментов документов, учитывая ограничения по длине промпта. Это поддерживается инструментами векторных баз данных (например, Azure Vector Search), которые извлекают полезные фрагменты из различных предопределённых источников данных и добавляют их в контекст промпта.
Эта техника очень полезна, когда у компании недостаточно данных, времени или ресурсов для дообучения (fine-tuning) LLM, но она всё же хочет улучшить производительность в конкретной рабочей нагрузке и снизить риски галлюцинаций, устаревших или неподдерживаемых ответов.
Дообученная (fine-tuned) модель
Дообучение (fine-tuning) представляет собой процесс, который использует трансферное обучение для «адаптации» модели к последующей задаче или для решения конкретной проблемы. В отличие от обучения с несколькими примерами (few-shot learning) и RAG, в результате дообучения создаётся новая модель с обновлёнными весами и смещениями. Для этого требуется набор обучающих примеров, состоящих из одного входного значения (промпта) и соответствующего ему выходного значения (завершения). Этот подход будет предпочтительным, если:
Использование меньших моделей, специфичных для задачи. Компания хочет дообучить меньшую модель для узкой задачи, а не многократно отправлять промпты более крупной передовой модели, что приведёт к более экономичному и быстрому решению.
Учёт задержки. Задержка важна для конкретного варианта использования, поэтому невозможно использовать очень длинные промпты или количество примеров, которые модель должна изучить, не соответствует ограничению длины промпта.
Адаптация стабильного поведения. У компании есть много высококачественных примеров, и она хочет, чтобы модель последовательно следовала шаблону задачи, формату вывода, тону или стилю, специфичному для предметной области. Если основная проблема заключается в свежих фактах или частных знаниях, которые часто меняются, используйте RAG вместо того, чтобы полагаться только на дообучение (fine-tuning).
Обученная модель
Обучение LLM с нуля, без сомнения, является самым сложным и комплексным подходом, требующим огромных объёмов данных, квалифицированных ресурсов и соответствующей вычислительной мощности. Этот вариант следует рассматривать только в сценарии, когда у компании есть специфический для предметной области вариант использования и большой объём данных, ориентированных на эту предметную область.
Проверка знаний
Какой подход может быть хорошим для улучшения результатов завершения LLM?
- Промпт-инжиниринг с контекстом
- RAG
- Дообученная (fine-tuned) модель
О: Все три подхода могут помочь. Начните с промпт-инжиниринга и контекста для быстрых улучшений, а RAG используйте, когда модели нужны актуальные факты или частные бизнес-данные. Выбирайте дообучение (fine-tuning), когда у вас достаточно высококачественных примеров и нужно, чтобы модель последовательно следовала задаче, формату, тону или шаблону предметной области.
🚀 Задание
Подробнее прочитайте о том, как вы можете использовать RAG для вашего бизнеса.
Отличная работа, продолжайте обучение
После завершения этого урока ознакомьтесь с нашей коллекцией по генеративному ИИ, чтобы продолжать повышать свои знания в области генеративного ИИ!
Переходите к Уроку 3, где мы рассмотрим, как ответственно создавать решения с генеративным ИИ!
Источник: урок курса Microsoft «Generative AI for Beginners», © Microsoft Corporation, лицензия MIT. Перевод и адаптация на русский: AI University. Мы не являемся официальным партнёром или представителем Microsoft.