Введение в генеративный ИИ и большие языковые модели
(Нажмите на изображение выше, чтобы посмотреть видео этого урока)
Генеративный ИИ представляет собой искусственный интеллект, способный генерировать текст, изображения и другие виды контента. Эта технология фантастична тем, что она демократизирует ИИ: любой человек может использовать её, имея лишь текстовый промпт, предложение, написанное на естественном языке. Вам не нужно изучать такие языки, как Java или SQL, чтобы добиться чего-то значимого. Всё, что вам нужно, это использовать свой язык, сформулировать желаемое, и модель ИИ выдаст вам предложение. Применения и влияние этой технологии огромны: вы можете писать или анализировать отчёты, создавать приложения и многое другое, и всё это за считанные секунды.
В этом курсе мы рассмотрим, как наш стартап использует генеративный ИИ для открытия новых сценариев в мире образования и как мы решаем неизбежные проблемы, связанные с социальными последствиями его применения и технологическими ограничениями.
Введение
В этом уроке будут рассмотрены:
- Введение в бизнес-сценарий: идея и миссия нашего стартапа.
- Генеративный ИИ и как мы пришли к текущему технологическому ландшафту.
- Внутреннее устройство большой языковой модели.
- Основные возможности и практические варианты использования больших языковых моделей.
Цели обучения
После завершения этого урока вы будете понимать:
- Что такое генеративный ИИ и как работают большие языковые модели.
- Как вы можете использовать большие языковые модели для различных вариантов применения, с акцентом на образовательные сценарии.
Сценарий: наш образовательный стартап
Генеративный искусственный интеллект (ИИ) представляет собой вершину технологий ИИ, раздвигая границы того, что когда-то считалось невозможным. Генеративные модели ИИ обладают рядом возможностей и применений, но в этом курсе мы рассмотрим, как они революционизируют образование на примере вымышленного стартапа. Мы будем называть этот стартап нашим стартапом. Наш стартап работает в сфере образования с амбициозной миссией:
повышение доступности обучения в глобальном масштабе, обеспечение равного доступа к образованию и предоставление персонализированного обучения каждому учащемуся в соответствии с его потребностями.
Команда нашего стартапа осознаёт, что мы не сможем достичь этой цели без использования одного из самых мощных инструментов современности: больших языковых моделей (LLM).
Ожидается, что генеративный ИИ произведёт революцию в том, как мы учимся и преподаём сегодня. У студентов появятся виртуальные учителя, доступные 24 часа в сутки, которые будут предоставлять огромные объёмы информации и примеров, а учителя смогут использовать инновационные инструменты для оценки своих учеников и предоставления обратной связи.
Для начала давайте определим некоторые базовые понятия и терминологию, которые мы будем использовать на протяжении всего курса.
Как появился генеративный ИИ?
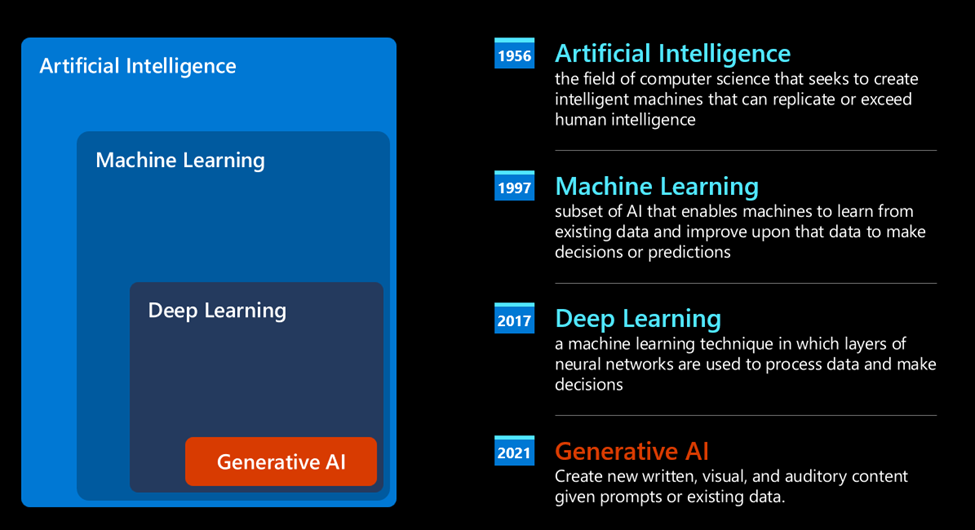
Несмотря на необычайный ажиотаж, созданный в последнее время анонсами генеративных моделей ИИ, эта технология разрабатывалась десятилетиями, а первые исследования датируются 60-ми годами. Сейчас мы находимся на этапе, когда ИИ обладает человеческими когнитивными способностями, такими как ведение беседы, что демонстрируют, например, OpenAI ChatGPT или Microsoft Copilot, который также использует модель GPT для своего разговорного веб-поиска.
Возвращаясь немного назад, самые первые прототипы ИИ представляли собой чат-боты с текстовым вводом, опирающиеся на базу знаний, извлечённую из группы экспертов и представленную в компьютере. Ответы в базе знаний запускались ключевыми словами, появляющимися во входном тексте. Однако вскоре стало ясно, что такой подход, использующий чат-боты с текстовым вводом, плохо масштабируется.
Статистический подход к ИИ: машинное обучение
Поворотный момент наступил в 90-х годах с применением статистического подхода к анализу текста. Это привело к разработке новых алгоритмов, известных как машинное обучение, способных изучать закономерности из данных без явного программирования. Этот подход позволяет машинам имитировать понимание человеческого языка: статистическая модель обучается на парах «текст-метка», что позволяет модели классифицировать неизвестный входной текст с заранее определённой меткой, представляющей намерение сообщения.
Нейронные сети и современные виртуальные помощники
В последние годы технологическая эволюция аппаратного обеспечения, способного обрабатывать большие объёмы данных и более сложные вычисления, стимулировала исследования в области ИИ, что привело к разработке продвинутых алгоритмов машинного обучения, известных как нейронные сети или алгоритмы глубокого обучения.
Нейронные сети (и в частности рекуррентные нейронные сети, RNN) значительно улучшили обработку естественного языка, позволив более осмысленно представлять значение текста, учитывая контекст слова в предложении.
Именно эта технология обеспечила работу виртуальных помощников, появившихся в первом десятилетии нового века, которые очень хорошо интерпретируют человеческий язык, выявляют потребность и выполняют действие для её удовлетворения, например, отвечают по заранее определённому сценарию или используют сторонний сервис.
Настоящее время: генеративный ИИ
Так мы и пришли к генеративному ИИ сегодня, который можно рассматривать как подмножество глубокого обучения.
После десятилетий исследований в области ИИ новая архитектура модели, называемая Transformer, преодолела ограничения RNN, получив возможность принимать на вход гораздо более длинные последовательности текста. Трансформеры основаны на механизме внимания, позволяющем модели придавать разный вес получаемым входным данным, «уделяя больше внимания» тому, где сосредоточена наиболее релевантная информация, независимо от её порядка в текстовой последовательности.
Большинство современных генеративных моделей ИИ, также известных как большие языковые модели (LLM), поскольку они работают с текстовыми входами и выходами, действительно основаны на этой архитектуре. Что интересно в этих моделях, обученных на огромном количестве неразмеченных данных из различных источников, таких как книги, статьи и веб-сайты, так это то, что они могут быть адаптированы к широкому спектру задач и генерировать грамматически правильный текст с подобием креативности. Таким образом, они не только невероятно улучшили способность машины «понимать» входной текст, но и позволили ей генерировать оригинальный ответ на человеческом языке.
Как работают большие языковые модели?
В следующей главе мы рассмотрим различные типы генеративных моделей ИИ, но пока давайте посмотрим, как работают большие языковые модели, с акцентом на модели OpenAI GPT (Generative Pre-trained Transformer).
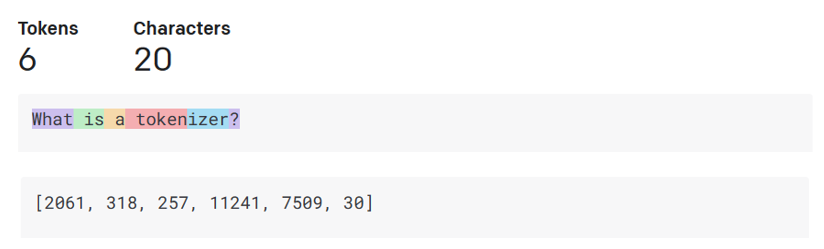
- Токенизатор, текст в числа: Большие языковые модели получают текст на вход и генерируют текст на выход. Однако, будучи статистическими моделями, они гораздо лучше работают с числами, чем с текстовыми последовательностями. Вот почему каждый вход в модель обрабатывается токенизатором, прежде чем использоваться основной моделью. Токен представляет собой фрагмент текста, состоящий из переменного числа символов, поэтому основная задача токенизатора заключается в разделении входных данных на массив токенов. Затем каждый токен сопоставляется с индексом токена, который является целочисленным кодированием исходного фрагмента текста.
Предсказание выходных токенов: Получив n токенов на входе (при этом максимальное n варьируется от одной модели к другой), модель способна предсказать один токен на выходе. Этот токен затем включается во вход следующей итерации по принципу расширяющегося окна, что обеспечивает лучший пользовательский опыт получения одного (или нескольких) предложений в качестве ответа. Это объясняет, почему, если вы когда-либо играли с ChatGPT, вы могли заметить, что иногда он как будто останавливается посреди предложения.
Процесс выбора, распределение вероятностей: Выходной токен выбирается моделью в соответствии с его вероятностью появления после текущей текстовой последовательности. Это происходит потому, что модель предсказывает распределение вероятностей по всем возможным «следующим токенам», рассчитанное на основе её обучения. Однако не всегда из полученного распределения выбирается токен с наибольшей вероятностью. В этот выбор добавляется некоторая степень случайности, так что модель действует недетерминированным образом: мы не получаем абсолютно одинаковый результат для одного и того же входа. Эта степень случайности добавляется для имитации процесса творческого мышления и может быть настроена с помощью параметра модели, называемого температурой.
Как наш стартап может использовать большие языковые модели?
Теперь, когда вы лучше понимаете внутреннее устройство большой языковой модели, давайте рассмотрим несколько практических примеров наиболее распространённых задач, с которыми они хорошо справляются, с учётом нашего бизнес-сценария. Мы говорили, что основная способность большой языковой модели: генерировать текст с нуля, начиная с текстового ввода, написанного на естественном языке.
Но что представляют собой такой текстовый ввод и вывод? Ввод большой языковой модели известен как промпт, а вывод: как завершение (completion). Этот термин относится к механизму модели, генерирующему следующий токен для завершения текущего ввода. Мы подробно рассмотрим, что такое промпт и как его проектировать, чтобы получить максимальную отдачу от модели. Но пока давайте просто скажем, что промпт может включать:
Инструкцию, указывающую тип вывода, который вы ожидаете от модели. Эта инструкция иногда может содержать примеры или дополнительные данные.
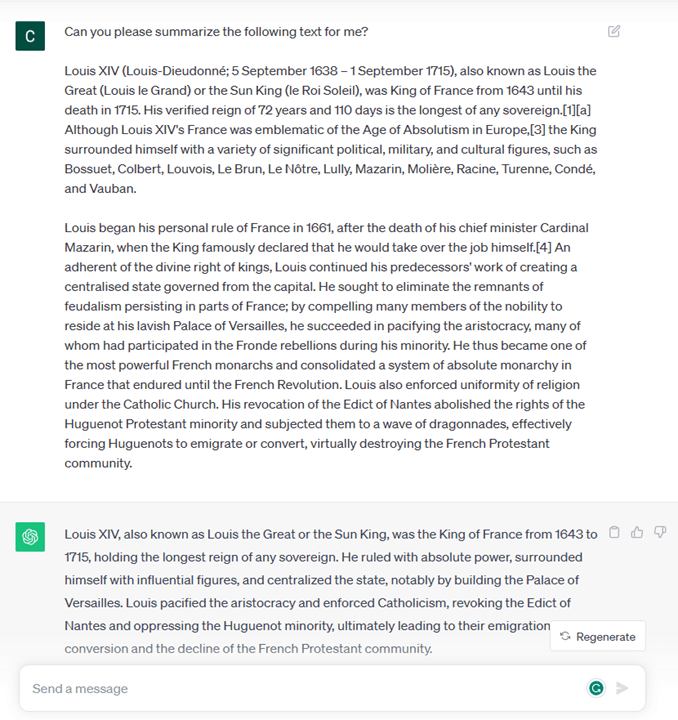
- Резюмирование статьи, книги, отзывов о продуктах и многого другого, а также извлечение инсайтов из неструктурированных данных.
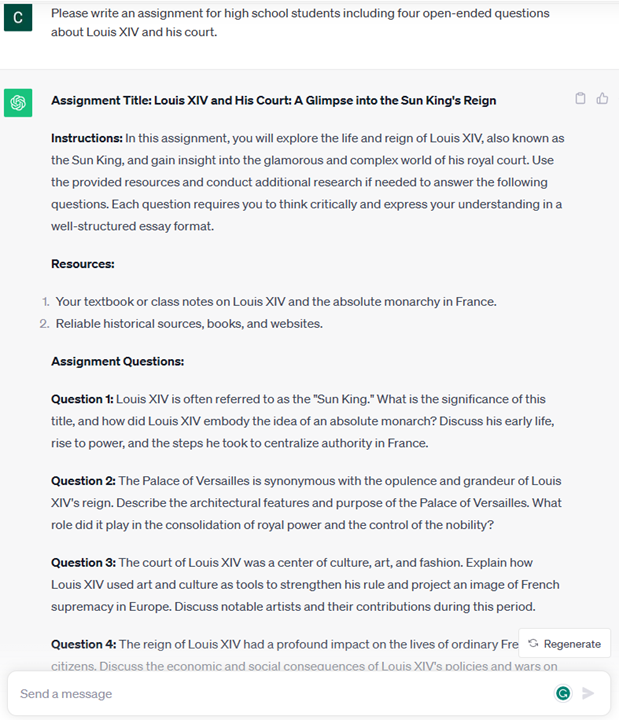
Креативное создание и разработка статьи, эссе, задания или чего-либо ещё.
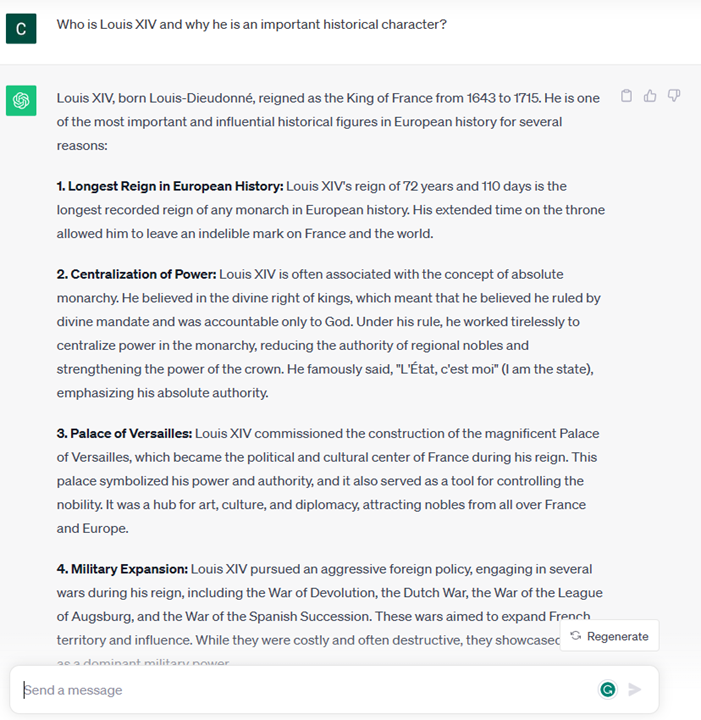
Вопрос, заданный в форме диалога с агентом.
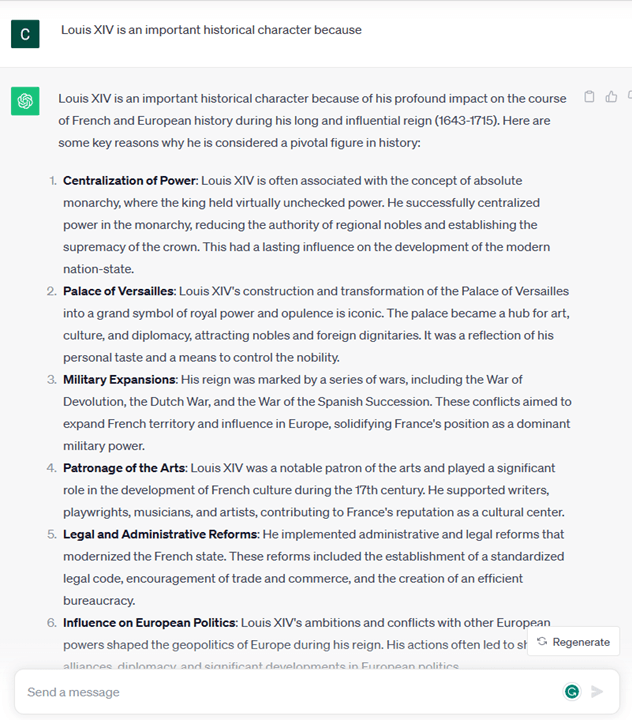
Фрагмент текста для завершения, что неявно является запросом на помощь в написании.
Фрагмент кода вместе с запросом на его объяснение и документирование, или комментарий с просьбой сгенерировать фрагмент кода, выполняющий определённую задачу.
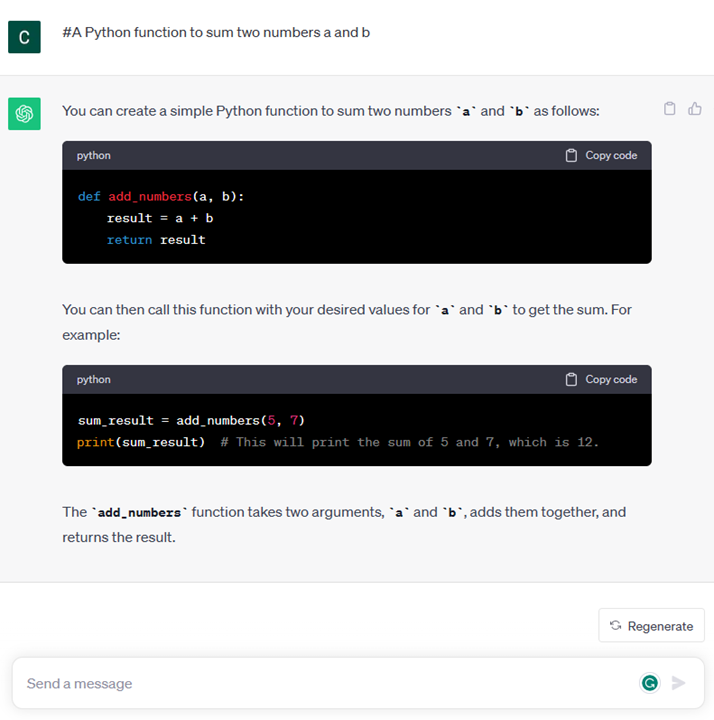
Приведённые выше примеры довольно просты и не претендуют на исчерпывающую демонстрацию возможностей больших языковых моделей. Они призваны показать потенциал использования генеративного ИИ, в частности, но не ограничиваясь образовательными контекстами.
Кроме того, вывод модели генеративного ИИ не идеален, и иногда креативность модели может сыграть против неё, приводя к выводу, который пользователь-человек может интерпретировать как мистификацию реальности или как оскорбительный. Генеративный ИИ не является интеллектуальным, по крайней мере, в более широком определении интеллекта, включающем критическое и творческое мышление или эмоциональный интеллект; он не детерминирован и не заслуживает полного доверия, поскольку вымыслы, такие как ошибочные ссылки, содержание и утверждения, могут сочетаться с правильной информацией и представляться убедительно и уверенно. В следующих уроках мы будем рассматривать все эти ограничения и увидим, что можно сделать для их смягчения.
Задание
Ваше задание: подробнее изучить генеративный ИИ и попытаться определить область, где вы бы сегодня внедрили генеративный ИИ, если его там ещё нет. Чем отличалось бы влияние от «старого способа»? Смогли бы вы сделать что-то, чего не могли раньше, или стали бы работать быстрее? Напишите 300-словное резюме того, как выглядел бы ваш идеальный ИИ-стартап, включив заголовки «Проблема», «Как я бы использовал ИИ», «Влияние» и, по желанию, бизнес-план.
Если вы выполнили это задание, возможно, вы готовы подать заявку в инкубатор Microsoft, Microsoft for Startups Founders Hub.
Проверка знаний
Что верно о больших языковых моделях?
- Вы получаете абсолютно одинаковый ответ каждый раз.
- Они делают всё идеально, отлично складывают числа, генерируют работающий код и т. д.
- Ответ может варьироваться, несмотря на использование одного и того же промпта. Они также отлично подходят для создания первого черновика чего-либо, будь то текст или код. Но вам нужно дорабатывать результаты.
О: 3, LLM является недетерминированной, ответ варьируется, однако вы можете контролировать это отклонение с помощью настройки температуры. Также не следует ожидать, что она будет делать всё идеально, её задача: выполнять тяжёлую работу за вас, что часто означает получение хорошей первой попытки, которую вам нужно постепенно улучшать.
Отличная работа! Продолжайте обучение
После завершения этого урока ознакомьтесь с нашей коллекцией по генеративному ИИ, чтобы продолжать повышать свои знания в области генеративного ИИ!
Переходите к Уроку 2, где мы рассмотрим, как исследовать и сравнивать различные типы LLM!
Источник: урок курса Microsoft «Generative AI for Beginners», © Microsoft Corporation, лицензия MIT. Перевод и адаптация на русский: AI University. Мы не являемся официальным партнёром или представителем Microsoft.