О чём урок
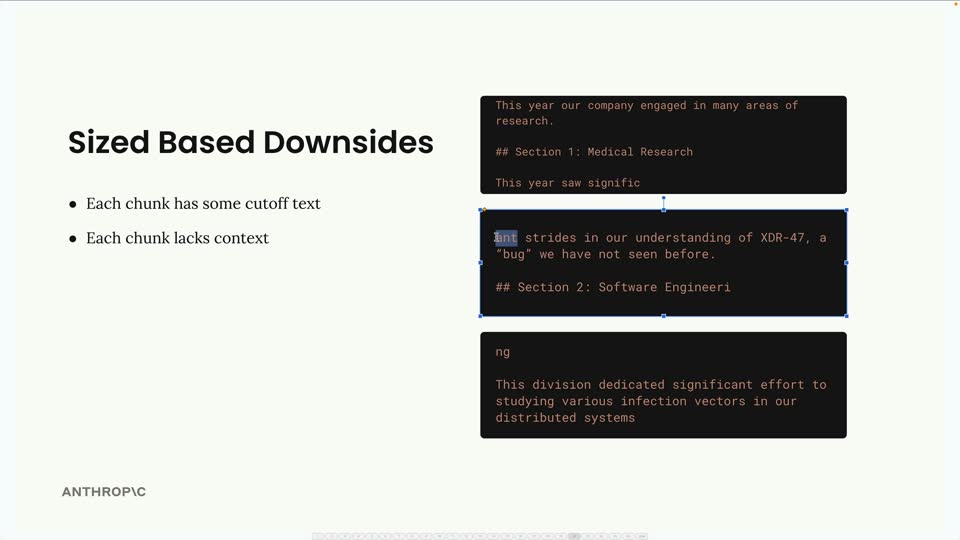
В мире искусственного интеллекта и больших языковых моделей (LLM) способность предоставлять точные и релевантные ответы является ключевой. Одним из наиболее эффективных подходов к улучшению качества ответов LLM, особенно при работе с обширными базами знаний, является использование архитектуры Retrieval Augmented Generation (RAG). Суть RAG заключается в том, что перед генерацией ответа LLM сначала "ищет" (retrieves) релевантную информацию из внешней базы данных, а затем использует ее для формирования более точного и контекстуально обоснованного ответа. Однако эффективность всей системы RAG критически зависит от одного из первых и самых важных шагов: разбиения текста на "чанки" (chunking). Чанкинг — это процесс деления больших документов на более мелкие, управляемые фрагменты текста, или "чанки". То, как вы разбиваете свои документы, напрямую влияет на качество всей вашей системы. Плохая стратегия чанкинга может привести к тому, что в ваши запросы будет вставлен нерелевантный контекст, что заставит ваш AI давать совершенно неправильные ответы. Представьте себе документ, содержащий разделы о медицинских исследованиях и о разработке программного обеспечения. Если вы примените неэффективную стратегию чанкинга, пользователь, задающий вопрос "Сколько ошибок (bugs) исправили инженеры в этом году?", может получить информацию о медицинских исследованиях вместо программной инженерии. Это произойдет просто потому, что медицинский раздел случайно содержал слово "bug" (например, "бактериальный баг" или "вирусный баг") в совершенно ином контексте. Этот пример наглядно демонстрирует, почему стратегия чанкинга так важна. Цель состоит в том, чтобы создавать чанки, которые сохраняют семантическую связность и предоставляют полезный контекст при извлечении. Существует три основных подхода к делению текста на чанки, каждый из которых имеет свои преимущества и недостатки, а также области применения: Разбиение по размеру (Size-Based Chunking): Деление текста на фрагменты примерно равной длины. Разбиение по структуре (Structure-Based Chunking): Деление на основе естественной структуры документа (заголовки, абзацы, разделы). Разбиение по предложениям/семантике (Sentence-Based/Semantic Chunking): Группировка связанных предложений или разделов с использованием методов обработки естественного языка (NLP).
План урока
- Введение: Что такое "Чанкинг" и почему он важен для RAG?
- Основные стратегии разбиения текста на чанки
- Стратегия разбиения по размеру (Size-Based Chunking)
- Стратегия разбиения по структуре (Structure-Based Chunking)
- Стратегия разбиения по предложениям (Sentence-Based Chunking)
- Выбор оптимальной стратегии
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.