О чём урок
В мире больших языковых моделей (LLM) и систем генерации с дополненной реальностью (RAG), способность находить точную и релевантную информацию является краеугольным камнем успеха. Представьте, что у вас есть огромная библиотека документов, и пользователь задает вопрос. Как быстро и точно найти те части текста, которые содержат ответ, даже если формулировка вопроса сильно отличается от текста в документах?
Именно здесь на сцену выходят векторные представления текста, или Text Embeddings. Они являются фундаментом для семантического поиска — метода, который позволяет компьютерам понимать смысл текста, а не просто искать совпадения по ключевым словам.
Прежде чем углубиться в суть Text Embeddings, давайте рассмотрим проблему, которую они решают. В типичном пайплайне RAG, после того как большой документ разбит на более мелкие фрагменты (или chunks), следующая задача — определить, какие из этих фрагментов наиболее релевантны запросу пользователя. Это, по сути, задача поиска: нужно просмотреть все текстовые фрагменты и выявить те, которые относятся к тому, о чем спрашивает пользователь.
Вызов заключается в определении того, какие фрагменты "связаны" с вопросом пользователя. Это не так просто, как сопоставление ключевых слов. Например, если пользователь спрашивает "Каковы преимущества использования солнечной энергии?", а в документе написано "Солнечные панели предлагают значительную экономию средств и снижение выбросов углекислого газа", простое сопоставление слов может не сработать, так как слова "преимущества" и "экономия средств" или "снижение выбросов" не совпадают напрямую. Нам нужно понимание смысла и контекста как вопроса, так и фрагментов.
Традиционный поиск по ключевым словам часто терпит неудачу, когда слова синонимичны, используются в разных формах или когда запрос и документ выражают одну и ту же идею совершенно разными словами. Для преодоления этого ограничения и был разработан семантический поиск.
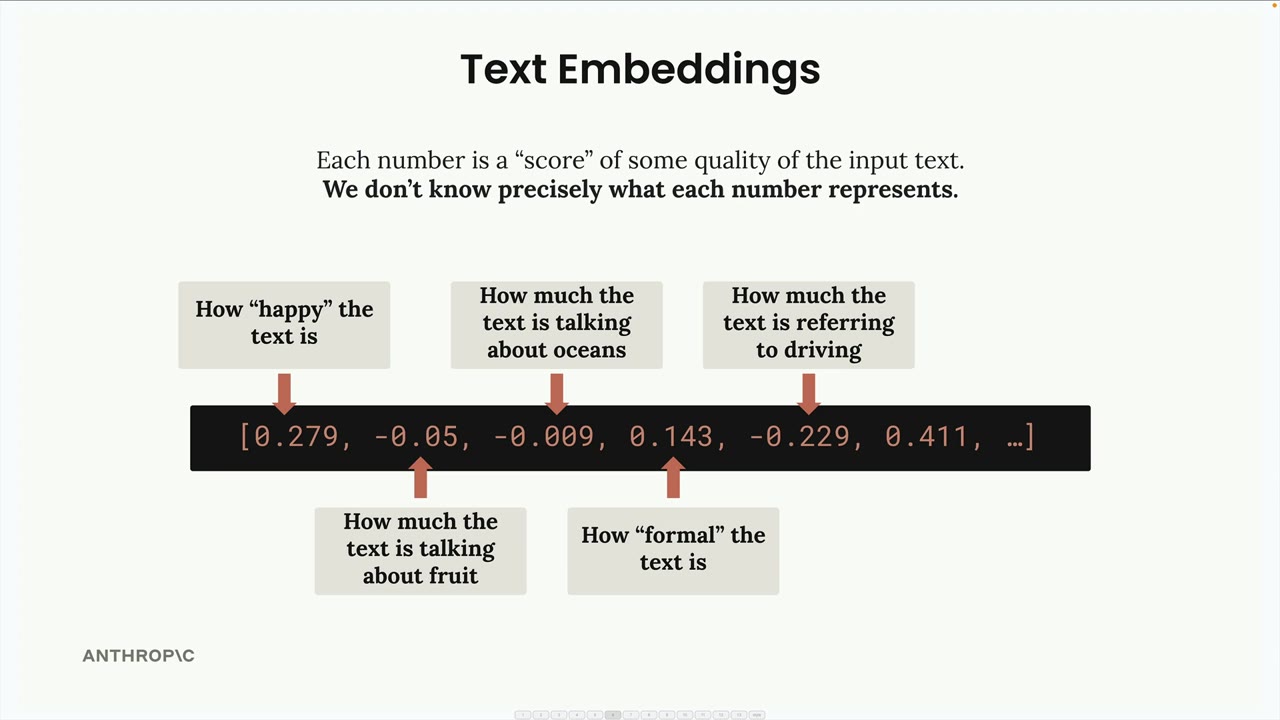
Text Embedding — это числовое представление смысла, содержащегося в некотором тексте. Представьте это как преобразование слов, фраз и предложений в формат, с которым компьютеры могут работать математически. Это своего рода "отпечаток пальца" текста, который улавливает его семантическую суть.
Вот как это…
План урока
- Векторные представления текста: Ключ к семантическому поиску в RAG
- Проблема поиска релевантных фрагментов
- Что такое векторные представления текста (Text Embeddings)?
- Как "читать" эти числа?
- Создание векторных представлений: практический подход
- Почему векторные представления так важны для RAG?
- Заключение
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.