О чём урок
В мире больших языковых моделей (LLM), таких как Claude, способность предоставлять точные, актуальные и контекстуально релевантные ответы имеет решающее значение. Однако, несмотря на их впечатляющие возможности, LLM иногда сталкиваются с ограничениями: они могут «галлюцинировать» (генерировать ложную информацию), их знания ограничены данными, на которых они были обучены, и им может не хватать специфической, актуальной или конфиденциальной информации из вашей собственной базы знаний. Здесь на помощь приходит подход Retrieval-Augmented Generation (RAG). RAG — это мощная методология, которая позволяет LLM получать доступ к внешней, актуальной информации и использовать ее для формирования своих ответов. Это значительно повышает точность, надежность и актуальность генерируемого контента. В этом уроке мы подробно рассмотрим, как реализовать полный рабочий процесс RAG, используя практический пример. Мы построим векторную базу данных с нуля и выполним все пять ключевых шагов рабочего процесса RAG, опираясь на пример документа-отчета. По своей сути, RAG — это метод, который обогащает процесс генерации ответов LLM путем извлечения релевантной информации из обширной базы данных. Вместо того чтобы полагаться исключительно на свои внутренние знания, LLM сначала ищет и находит соответствующие фрагменты данных, а затем использует их в качестве дополнительного контекста для формирования ответа. Представьте, что вы даете LLM не просто вопрос, а вопрос и несколько страниц текста, которые, по вашему мнению, содержат ответ. Преимущества RAG многочисленны: Повышенная точность: LLM получает доступ к проверенным фактам, что снижает вероятность «галлюцинаций». Актуальность: Система может использовать самую свежую информацию, которая не была включена в исходные обучающие данные модели. Специфичность домена: RAG позволяет LLM отвечать на вопросы, требующие глубоких знаний в конкретной области, используя вашу собственную документацию. Прозрачность: Часто можно указать источник извлеченной информации, что повышает доверие к ответам. В контексте использования Claude через Amazon Bedrock, RAG становится особенно ценным инструментом, позволяющим интегрировать ваши корпоративные данные с возможностями передовых моделей Anthropic, обеспечивая при этом масштабируемость и безопасность облачной инфраструктуры AWS.
План урока
- Введение в Retrieval-Augmented Generation (RAG) с Claude в Amazon Bedrock
- Что такое RAG (Retrieval-Augmented Generation)?
- Основы векторных баз данных
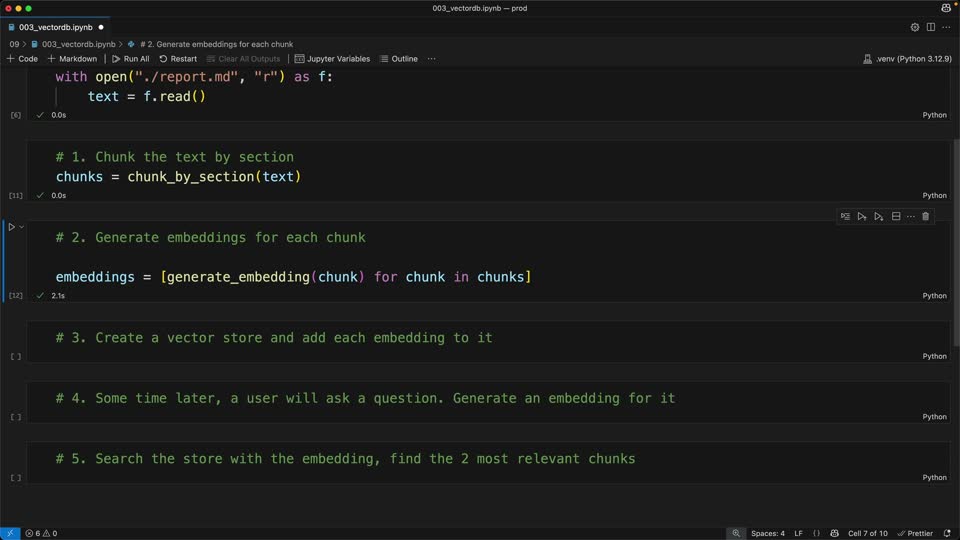
- Пошаговая реализация RAG: От документа к ответу
- Шаг 1: Разделение текста на фрагменты (Chunking)
- Шаг 2: Генерация эмбеддингов для каждого фрагмента
- Шаг 3: Сохранение эмбеддингов в векторной базе данных
- Шаг 4: Генерация эмбеддинга пользовательского запроса
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.