О чём урок
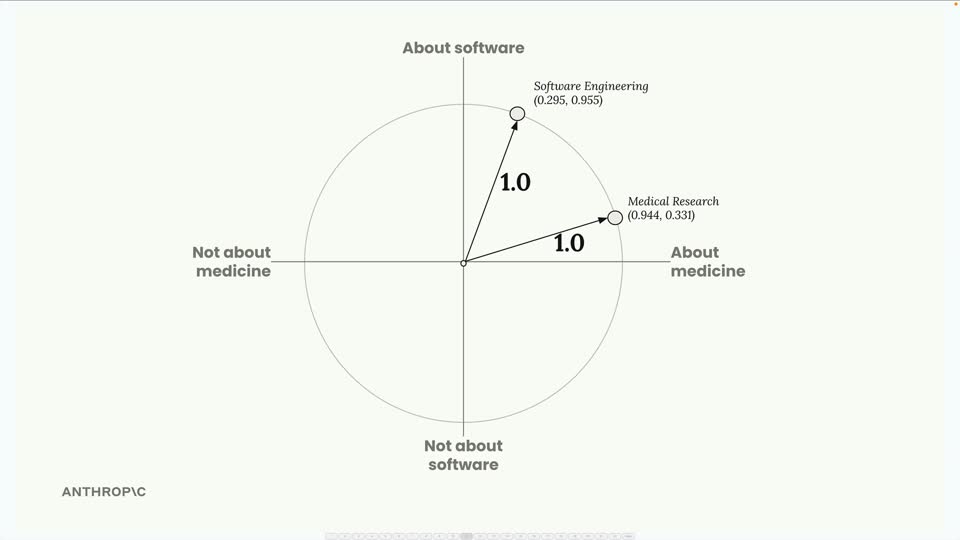
В мире больших языковых моделей (LLM), таких как Claude, способность предоставлять точную, актуальную и специфическую информацию является ключевой. Однако LLM обучены на огромных, но фиксированных наборах данных, что означает, что они могут не знать о самых последних событиях, внутренних документах вашей компании или очень специфических деталях, не вошедших в их тренировочные данные. Здесь на помощь приходит Retrieval Augmented Generation (RAG) — мощный подход, который позволяет LLM получать доступ к внешней, актуальной информации и использовать ее для формирования своих ответов. Теперь, когда мы рассмотрели основы RAG, разбиения текста на фрагменты (chunking) и создания эмбеддингов (embeddings), давайте подробно разберем полный конвейер RAG шаг за шагом. Этот детальный пример покажет вам, как все части головоломки соединяются в реальной реализации, позволяя Claude отвечать на вопросы, используя вашу собственную базу знаний. Первый шаг в любом RAG-системе — это подготовка вашей исходной информации. Мы берем наш исходный документ (или набор документов) и разбиваем его на управляемые, осмысленные фрагменты текста. Цель состоит в том, чтобы каждый фрагмент был достаточно мал, чтобы его можно было эффективно обработать, но достаточно велик, чтобы содержать связную идею или контекст. Для нашего примера мы будем использовать два простых текстовых фрагмента: Фрагмент 1: Медицинские исследования - "This year saw significant strides in our understanding of XDR-47, a 'bug' we have not seen before." (В этом году были достигнуты значительные успехи в нашем понимании XDR-47, "жучка", которого мы раньше не встречали.) Фрагмент 2: Разработка программного обеспечения - "This division dedicated significant effort to studying various infection vectors in our distributed systems." (Этот отдел приложил значительные усилия для изучения различных векторов заражения в наших распределенных системах.) Выбор оптимального размера фрагмента и стратегии разбиения (например, по предложениям, абзацам или фиксированному количеству слов/токенов) является важным аспектом настройки RAG-системы, который может существенно повлиять на качество извлекаемой информации.
План урока
- Введение в полный цикл RAG: Расширяем возможности Claude в Amazon Bedrock
- Шаг 1: Разбиение исходного текста на фрагменты (Chunking)
- Шаг 2: Создание эмбеддингов
- Шаг 3: Хранение в векторной базе данных
- Шаг 4: Обработка запроса пользователя
- Шаг 5: Поиск похожих эмбеддингов
- Как работает сходство: Косинусное сходство (Cosine Similarity)
- Шаг 6: Формирование итогового промпта для Claude
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.