О чём урок
В процессе создания систем на основе больших языковых моделей (LLM), таких как Claude, часто возникает задача предоставления модели доступа к обширной и актуальной информации, которая не была включена в её первоначальный обучающий набор данных. Для этого используется подход, известный как Retrieval Augmented Generation (RAG). Ключевым этапом в конвейере RAG является поиск наиболее релевантных фрагментов текста из вашей базы знаний, которые соответствуют запросу пользователя.
Представьте, что у вас есть огромный документ или целая библиотека текстов. Когда пользователь задает вопрос, вам нужно быстро найти те части, которые содержат ответ или наиболее тесно связаны с темой запроса. Это, по сути, задача поиска. Традиционные методы поиска, основанные на ключевых словах, могут быть неэффективны, поскольку они требуют точного совпадения слов. Например, запрос "столица Франции" не найдет ответ в тексте, где написано "Париж – главный город Франции", если система ищет только по ключевым словам.
Здесь на помощь приходит семантический поиск. В отличие от поиска по ключевым словам, семантический поиск не просто ищет совпадения слов, а стремится понять истинное значение как запроса пользователя, так и каждого фрагмента текста. Это позволяет системе находить концептуально связанные материалы, даже если точные формулировки слов не совпадают. Основой семантического поиска являются текстовые эмбеддинги.
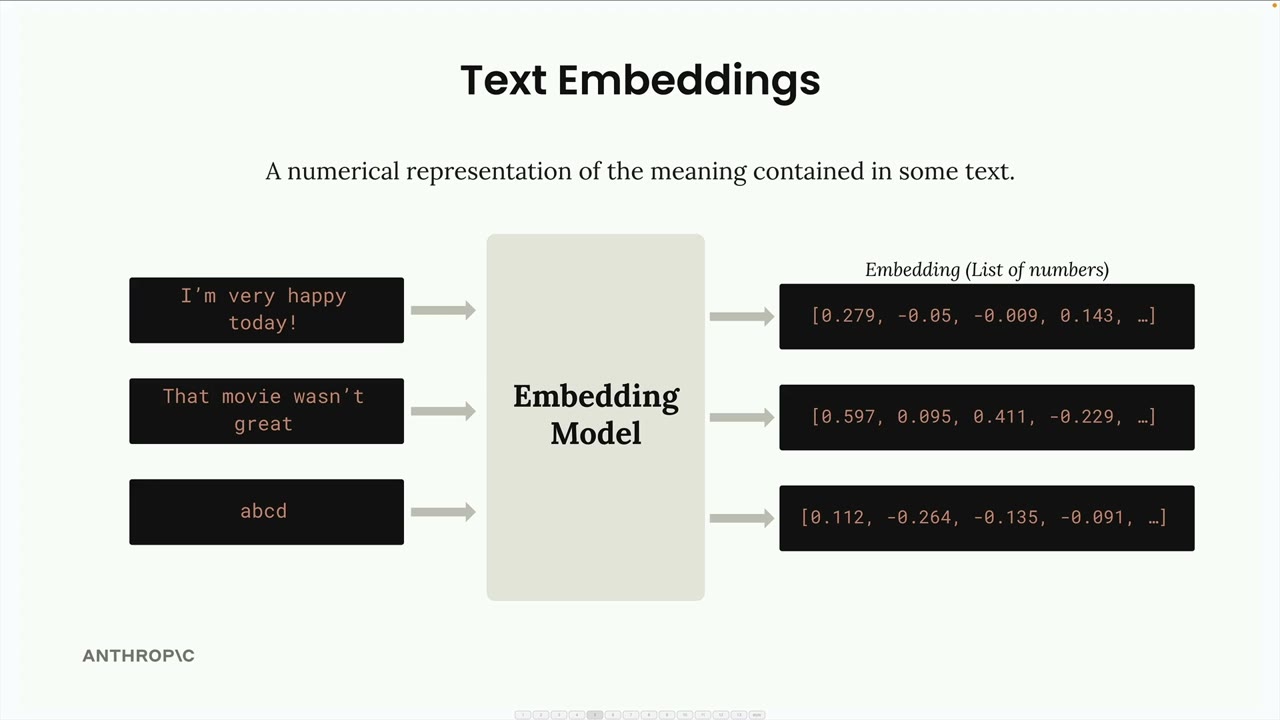
Текстовый эмбеддинг (от англ. text embedding) — это числовое представление смысла, заключенного в некотором тексте. Проще говоря, это способ преобразования слов, предложений или целых абзацев в формат, с которым компьютеры могут работать математически. Вместо того чтобы оперировать буквами и словами, которые для машины являются просто символами, мы получаем вектор чисел, который "кодирует" семантическое значение текста.
Представьте, что каждое слово или фраза может быть помещено в многомерное пространство, где близко расположенные точки представляют слова или фразы со схожим значением. Эмбеддинг — это координаты этой точки в данном пространстве. Чем ближе два эмбеддинга друг к другу в этом пространстве, тем более схожим считается их семантическое значение.
Процесс создания эмбеддингов довольно прост с точки зрения…
План урока
- Введение: От фрагментов к смыслу с помощью семантического поиска
- Что такое текстовые эмбеддинги?
- Как работают эмбеддинги?
- Непрозрачность и мощь эмбеддингов
- Генерация эмбеддингов в Google Vertex AI
- Дальнейшие шаги: Сравнение эмбеддингов
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.