О чём урок
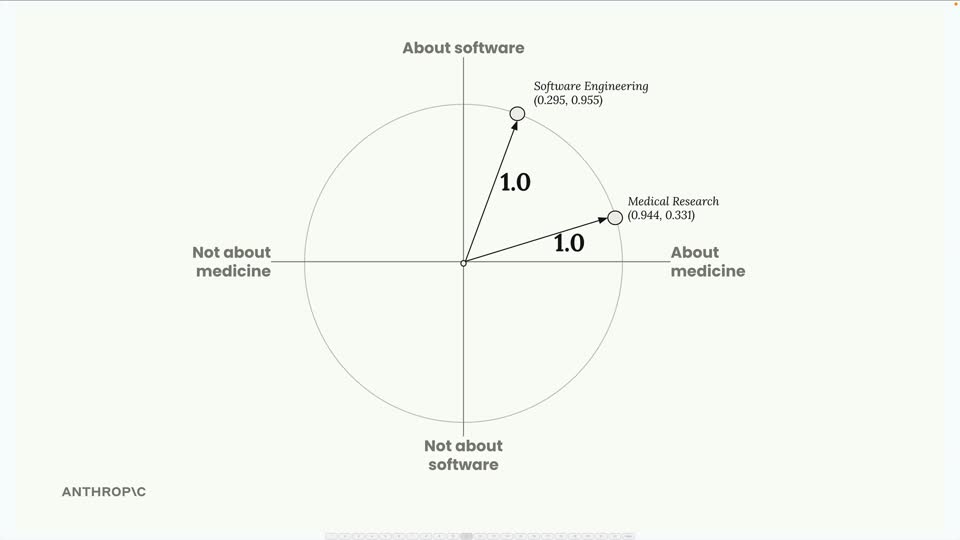
В мире больших языковых моделей (LLM), таких как Claude, способность отвечать на вопросы, основываясь на актуальной и специфической информации, имеет решающее значение. Именно здесь на сцену выходит RAG (Retrieval Augmented Generation — генерация с дополненным поиском). RAG — это мощный подход, который позволяет LLM получать доступ к внешним источникам данных и использовать их для формирования более точных, актуальных и менее "галлюцинаторных" ответов. Он расширяет знания модели за пределы ее первоначального обучения, позволяя ей работать с вашими собственными документами, базами данных или веб-контентом. Мы уже рассмотрели основы RAG, принципы разделения текста на "чанки" (chunking) и создания эмбеддингов (embeddings). Теперь давайте подробно разберем полный цикл RAG шаг за шагом, чтобы понять, как все эти компоненты взаимодействуют в реальной системе, позволяя Claude предоставлять ответы, основанные на ваших уникальных данных. Первый этап в любом RAG-процессе — это подготовка исходных данных. Ваши документы, будь то отчеты, статьи или руководства, должны быть обработаны таким образом, чтобы LLM могла эффективно их использовать. Представьте, что у вас есть очень длинный документ. Если передать его целиком в LLM, это может превысить лимит токенов, а также затруднит модели поиск наиболее релевантной информации. Поэтому первым шагом мы берем исходный документ и разбиваем его на более мелкие, управляемые фрагменты, или "чанки". Размер этих чанков оптимизируется для сохранения контекста, но при этом они должны быть достаточно короткими для эффективной обработки. Для нашего примера представим, что у нас есть два простых текстовых фрагмента: Раздел 1: Медицинские исследования - "В этом году были достигнуты значительные успехи в нашем понимании XDR-47, 'бактерии', которую мы ранее не встречали." Раздел 2: Разработка программного обеспечения - "Этот отдел приложил значительные усилия для изучения различных векторов заражения в наших распределенных системах." После того как текст разбит на чанки, каждый из них преобразуется в числовое представление, называемое эмбеддингом. Эмбеддинги — это многомерные векторы (списки чисел), которые улавливают семантическое значение текста.
План урока
- Полный цикл RAG: как Claude использует ваши данные для точных ответов
- Подготовка данных: Разделение и Векторизация
- Разделение исходного текста на "чанки" (Chunking)
- Генерация эмбеддингов (Embeddings)
- Хранение и Поиск: Векторная База Данных
- Сохранение эмбеддингов в векторной базе данных
- Обработка пользовательского запроса
- Поиск релевантности: Косинусное сходство
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.