О чём урок
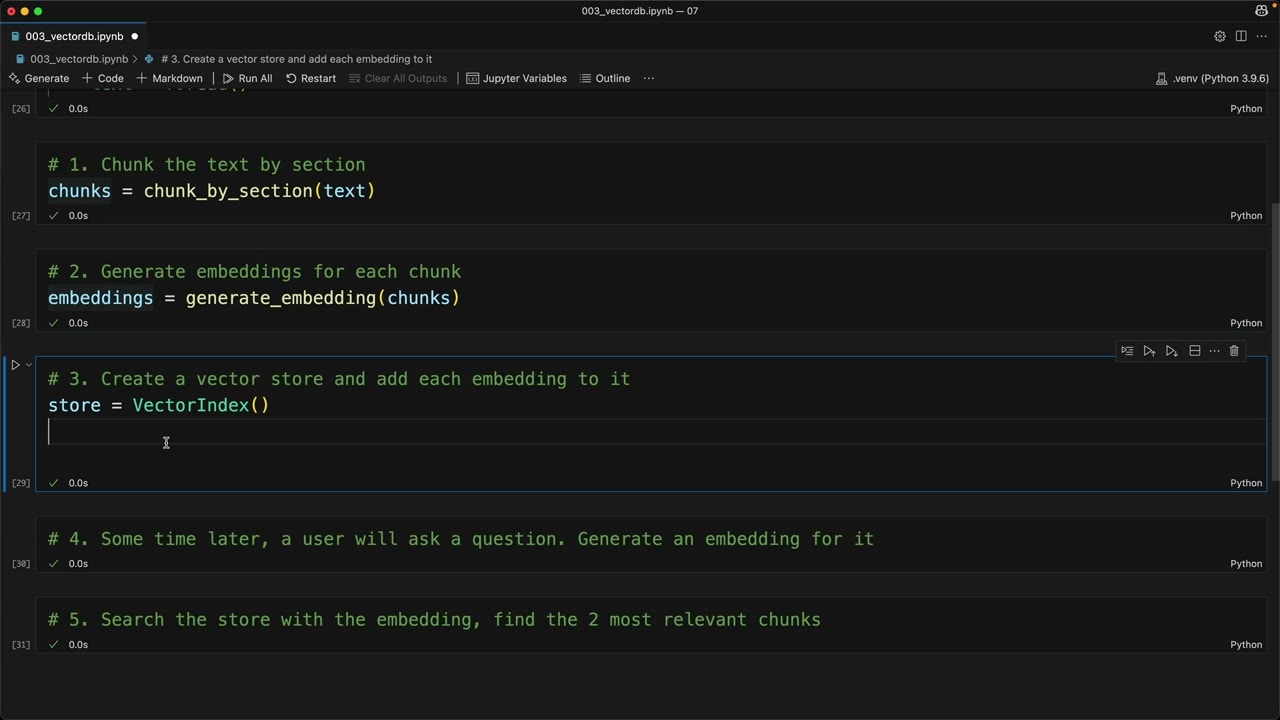
В мире больших языковых моделей (LLM), таких как Claude, способность получать и использовать внешнюю информацию является ключевой для создания по-настоящему мощных и актуальных приложений. Именно здесь на сцену выходит Retrieval-Augmented Generation (RAG) – подход, который позволяет LLM выходить за рамки своих изначально обученных знаний, обращаясь к внешним источникам данных. Концептуально мы уже понимаем, как работает RAG, а теперь давайте углубимся в его практическую реализацию, пройдя все пять этапов этого процесса на конкретном примере.
Мы рассмотрим каждый шаг: от разбиения исходного текста на управляемые фрагменты до поиска наиболее релевантных документов в ответ на запрос пользователя. Этот процесс является основой для создания систем, которые могут отвечать на вопросы, обобщать информацию и генерировать контент, опираясь на актуальные и специфические для предметной области данные.
Центральным элементом любой RAG-системы является векторная база данных. Это специализированное хранилище, предназначенное для эффективного хранения и поиска числовых представлений текста, известных как embeddings. Для нашей реализации мы будем использовать концепцию, аналогичную классу VectorIndex, который предоставляет базовую функциональность, необходимую для хранения векторов и выполнения поиска.
Векторная база данных обрабатывает несколько ключевых задач:
- Хранение векторов: Она эффективно сохраняет многомерные числовые векторы, которые представляют семантическое значение текстовых фрагментов.
- Вычисление расстояния: Для определения сходства между векторами используются алгоритмы, такие как cosine similarity (косинусное сходство). Чем ближе векторы в многомерном пространстве, тем более семантически похожи их исходные тексты.
- Извлечение документов: На основе вычисленного сходства база данных может быстро извлекать наиболее релевантные фрагменты текста, соответствующие заданному запросу.
По сути, векторная база данных служит "памятью" нашей системы RAG, позволяя ей быстро находить нужную информацию среди огромного объема данных.
Давайте подробно рассмотрим каждый этап процесса RAG, чтобы понять, как он работает на практике.
Первый шаг в процессе RAG — это подготовка исходного документа. Большие документы не могут быть целиком переданы в LLM из-за ограничений на размер контекстного окна (количество tokens, которые модель может обработать за один раз).
Поэтому мы разбиваем…
План урока
- Внедрение рабочего процесса RAG: Пошаговое руководство
- Подготовка векторной базы данных
- Пять шагов реализации RAG
- Шаг 1: Разделение текста на фрагменты (Chunking)
- Шаг 2: Генерация эмбеддингов для каждого фрагмента
- Шаг 3: Хранение эмбеддингов в векторной базе данных
- Шаг 4: Генерация эмбеддинга для пользовательского запроса
- Шаг 5: Поиск релевантных документов
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.