О чём урок
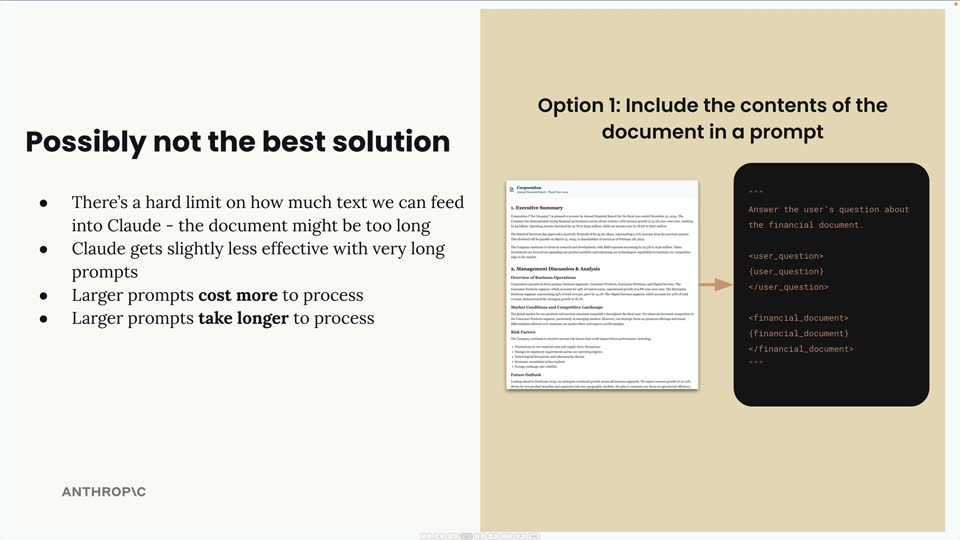
В мире больших языковых моделей (LLM), таких как Claude, мы часто сталкиваемся с необходимостью обработки огромных объемов информации. Эти модели невероятно мощны, но у них есть одно фундаментальное ограничение: размер контекстного окна (context window), то есть максимальное количество token'ов, которое они могут обработать за один запрос (prompt). Именно здесь на помощь приходит техника, известная как Retrieval Augmented Generation (RAG). RAG — это подход, который позволяет Claude эффективно работать с очень большими документами или целыми базами знаний, которые значительно превышают лимиты одного запроса, предоставляя модели только самую релевантную информацию в нужный момент. Представьте, что у вас есть 800-страничный финансовый отчет, и вы хотите задать Claude очень конкретный вопрос, например: "Какие факторы риска указаны для этой компании?". Чтобы получить точный ответ, Claude должен иметь доступ к соответствующей информации из документа. Однако, как мы уже упоминали, существует жесткий лимит на объем текста, который можно включить в один prompt. Первый, самый очевидный подход — это попытаться включить весь текст документа в ваш prompt вместе с вопросом пользователя. Ваш запрос мог бы выглядеть примерно так: Этот подход имеет серьезные ограничения, которые делают его непрактичным для большинства реальных сценариев: Жесткий лимит на длину prompt'а: Ваш документ, скорее всего, будет слишком длинным и превысит максимальное количество token'ов, которое Claude может обработать. Снижение эффективности: Даже если документ помещается в контекстное окно, Claude становится менее эффективным при работе с очень длинными prompt'ами. Модели сложнее "фокусироваться" на действительно важной информации среди огромного объема текста. Высокая стоимость: Обработка больших prompt'ов требует больше вычислительных ресурсов, что напрямую влияет на стоимость использования API. Увеличенное время обработки: Чем больше token'ов в prompt'е, тем дольше Claude будет генерировать ответ. Таким образом, простое "запихивание" всего документа в prompt не является масштабируемым или экономически эффективным решением. RAG предлагает гораздо более интеллектуальный и масштабируемый подход к работе с большими объемами данных.
План урока
- Введение в Retrieval Augmented Generation (RAG)
- Проблема работы с большими документами
- Решение: Retrieval Augmented Generation (RAG)
- Вызовы и соображения при использовании RAG
- Заключение
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.