О чём урок
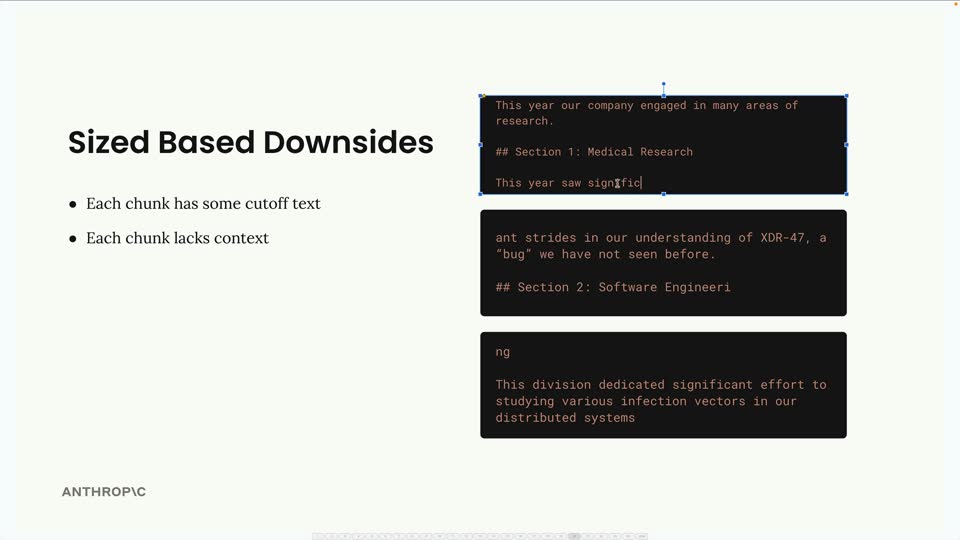
В мире больших языковых моделей (LLM), таких как Claude, способность эффективно работать с обширными объемами информации является ключевой. Однако у LLM есть ограничения по длине контекста, то есть по объему текста, который они могут обработать за один раз. Именно здесь на помощь приходит Retrieval Augmented Generation (RAG) — мощный подход, который позволяет моделям обращаться к внешней базе знаний для получения релевантной информации перед генерацией ответа. И одним из самых критически важных шагов в создании эффективного RAG-пайплайна является разбиение текста на фрагменты (text chunking). То, как вы разбиваете исходные документы на более мелкие, управляемые фрагменты, напрямую влияет на качество всей вашей системы. Неудачная стратегия разбиения может привести к тому, что в запрос к AI будет включен нерелевантный контекст, что, в свою очередь, заставит модель давать совершенно неверные или бесполезные ответы. Представьте себе ситуацию: у вас есть документ, содержащий разделы о медицинских исследованиях и о разработке программного обеспечения. Если вы разобьете его плохо, пользователь, спрашивающий "Сколько ошибок (bugs) исправили инженеры в этом году?", может получить информацию о медицинских исследованиях вместо программной инженерии, просто потому, что в медицинском разделе случайно встретилось слово "bug" в совершенно ином контексте (например, "бактериальный баг"). Именно поэтому выбор правильной стратегии разбиения текста так важен. Давайте рассмотрим три основных подхода, а также один практический компромисс. Разбиение по размеру — это самый простой и прямолинейный подход. Вы просто делите ваш текст на строки или последовательности символов (или токенов) фиксированной длины. Например, если у вас есть документ на 325 символов, вы можете разбить его на три фрагмента примерно по 108 символов каждый. Преимущества: Простота реализации: Этот метод легко запрограммировать и применить. Универсальность: Работает с любым типом документа, независимо от его структуры. Недостатки: Обрыв слов и предложений: Слова могут быть разрезаны посередине, предложения — оборваны, что затрудняет понимание. Потеря важного контекста: Фрагменты могут потерять смысл, если важная информация находится в соседнем фрагменте.
План урока
- Стратегии разбиения текста на фрагменты (Text Chunking Strategies)
- 1. Разбиение по размеру (Size-Based Chunking)
- 2. Разбиение по структуре (Structure-Based Chunking)
- 3. Разбиение по смыслу (Semantic-Based Chunking)
- 4. Разбиение по предложениям (Sentence-Based Chunking)
- Выбор оптимальной стратегии
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.