О чём урок
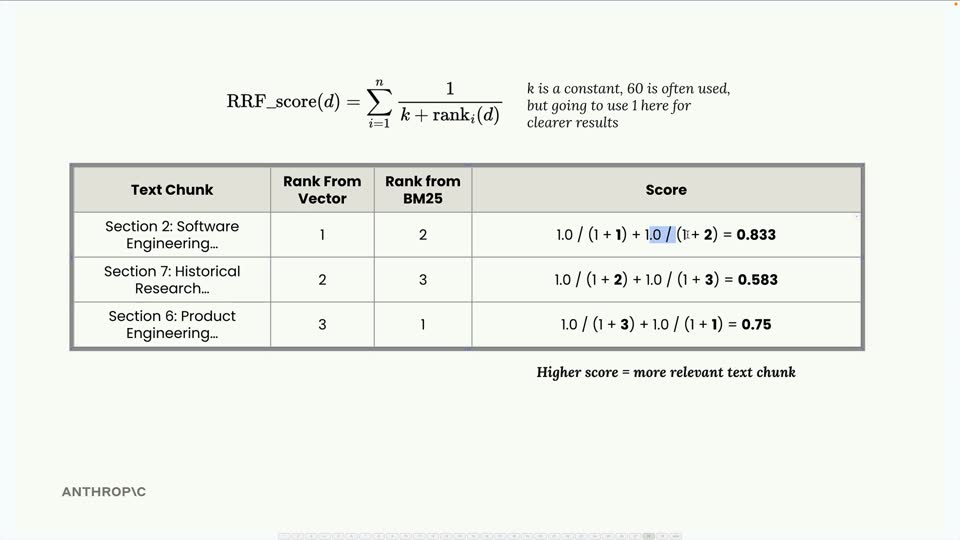
В мире больших языковых моделей (LLM) и систем генерации с дополненной реальностью (RAG) способность эффективно находить и извлекать релевантную информацию является ключевой. Мы уже рассматривали два мощных подхода к поиску: семантический поиск, использующий векторные эмбеддинги для понимания смысла запроса, и лексический поиск, такой как BM25, который фокусируется на совпадении ключевых слов. Каждый из этих методов имеет свои сильные стороны и ограничения. Семантический поиск отлично справляется с синонимами и концептуально схожими запросами, но может пропустить точные совпадения по редким терминам. Лексический поиск, наоборот, очень точен для ключевых слов, но не понимает контекст и может пропустить релевантные документы, использующие другую формулировку. Чтобы преодолеть эти ограничения и создать более надежную и точную систему извлечения информации, нам необходимо объединить сильные стороны обоих подходов. Цель этого урока — разработать многоиндексный конвейер RAG, который использует гибридную стратегию поиска, обеспечивая превосходные результаты. Основой нашего гибридного подхода является архитектура, которая позволяет нам использовать несколько различных поисковых индексов одновременно. Представьте, что у нас есть два специализированных "эксперта" по поиску: один — VectorIndex, который мастерски находит документы по их смысловому сходству, и другой — BM25Index, который виртуозно ищет по ключевым словам. Важно, что оба этих "эксперта" имеют схожий API, то есть они предоставляют одинаковые методы для добавления документов (например, add_document) и выполнения поиска (например, search). Эта согласованность API позволяет нам создать класс-координатор, который мы назовем Retriever. Retriever действует как центральный диспетчер: он принимает пользовательский запрос, перенаправляет его обоим индексам (VectorIndex и BM25Index), собирает их независимые результаты, а затем объединяет их с помощью специальной техники, называемой Reciprocal Rank Fusion (RRF). Такая модульная архитектура обеспечивает гибкость и позволяет легко добавлять новые методы поиска в будущем. Объединение результатов, полученных от разных поисковых методов, — это не простое склеивание списков. Каждый метод использует свою собственную систему оценки и ранжирования, поэтому нам нужен способ нормализовать и справедливо скомбинировать их рейтинги.
План урока
- Введение: Преодолевая ограничения поиска в RAG
- Архитектура многоиндексного поиска
- Объединение результатов: Метод Reciprocal Rank Fusion (RRF)
- Реализация класса Retriever
- Преимущества гибридного подхода: Улучшенные результаты
- Расширяемость и модульность
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.