О чём урок
При разработке систем на основе больших языковых моделей (LLM), таких как Claude, часто возникает необходимость предоставить модели доступ к актуальной и специфической информации, которой нет в ее исходных тренировочных данных. Для этого используется подход, известный как Retrieval Augmented Generation (RAG). Суть RAG заключается в том, чтобы сначала найти релевантные фрагменты информации из большой базы данных, а затем передать их LLM в качестве контекста для генерации ответа. Однако, как показывает практика, полагаться исключительно на один тип поиска в RAG-пайплайнах не всегда оптимально. В этой статье мы рассмотрим, почему чисто семантический поиск может быть недостаточным и как алгоритм BM25, используемый для лексического поиска, помогает создать более надежную и точную систему. Семантический поиск — это мощный инструмент, который революционизировал способ взаимодействия с информацией. Он основан на использовании эмбеддингов (векторных представлений слов, фраз или целых документов), которые улавливают их смысловое значение. Когда вы задаете запрос, система преобразует его в эмбеддинг и ищет в базе данных документы, чьи эмбеддинги наиболее близки к запросу в векторном пространстве. Это позволяет находить информацию, которая концептуально связана с вашим запросом, даже если в ней не используются те же самые слова. Например, если вы ищете "столица Франции", семантический поиск легко найдет документы, где упоминается "Париж", "город любви" или "Эйфелева башня", поскольку все эти понятия семантически связаны. Это его сильная сторона. Однако у этого подхода есть и обратная сторона. Представьте, что вы ищете конкретный идентификатор инцидента, например, "INC-2023-Q4-011", в большом корпоративном документе. Семантический поиск, фокусируясь на контексте и значении, может вернуть разделы, которые семантически связаны с темой кибербезопасности или инцидентов, но при этом не содержат точного совпадения с искомым ID. Он может даже вернуть разделы, которые вообще не упоминают этот ID, но кажутся ему "близкими" по смыслу к другим частям документа, где ID все же присутствует. Это происходит потому, что для семантического поиска важнее концептуальное сходство, а не точное совпадение терминов.
План урока
- Гибридный поиск: Сочетание семантического и лексического поиска с BM25 для RAG-систем
- Проблемы чисто семантического поиска
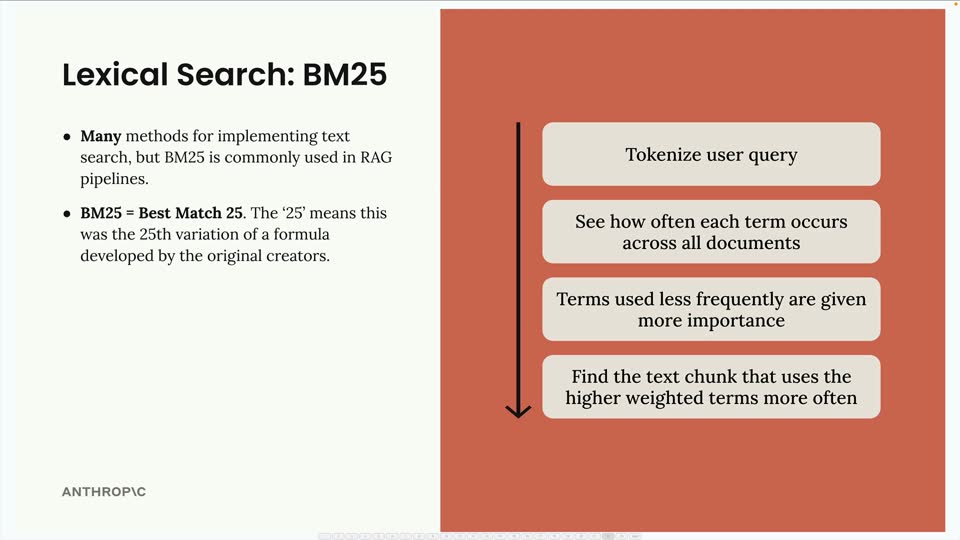
- Введение в лексический поиск и алгоритм BM25
- Как работает алгоритм BM25?
- Преимущества BM25 в RAG-системах
- Гибридный поиск: объединение сил
- Заключение
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.