О чём урок
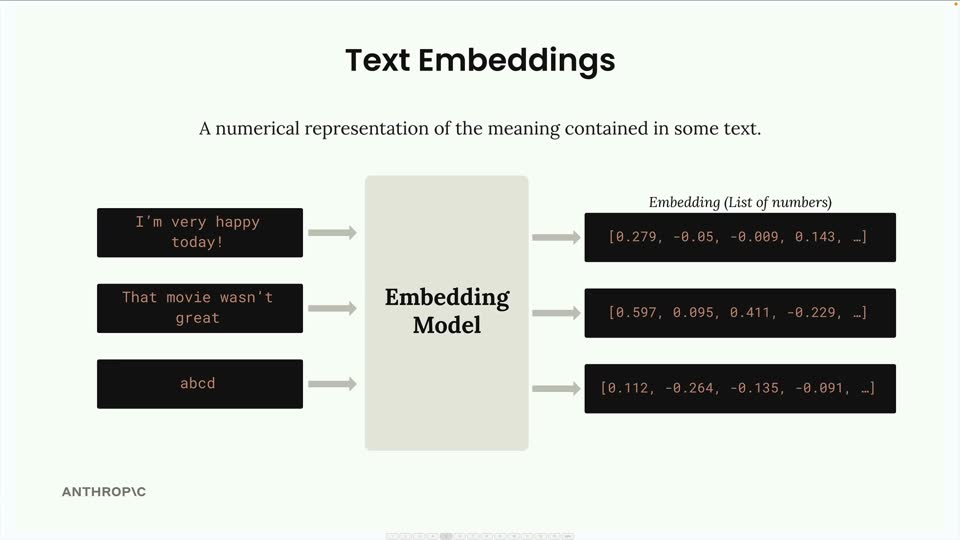
В мире больших данных и обширных текстовых коллекций, таких как документация, статьи или пользовательские запросы, поиск релевантной информации становится ключевой задачей. Особенно это актуально для систем, использующих архитектуру Retrieval Augmented Generation (RAG), где необходимо извлечь наиболее подходящие фрагменты текста для генерации точного и контекстуально верного ответа. Представьте, что у вас есть огромный документ, разбитый на множество небольших частей, или "чанков". Следующий шаг в пайплайне RAG — это определение, какие из этих чанков наиболее релевантны вопросу пользователя. По сути, это задача поиска: нужно просмотреть все текстовые чанки и выявить те, которые относятся к тому, о чем спрашивает пользователь. Наиболее распространенный подход для нахождения релевантных чанков — это семантический поиск. В отличие от поиска по ключевым словам, который ищет точные совпадения слов, семантический поиск использует текстовые эмбеддинги (text embeddings) для понимания значения и контекста как вопроса пользователя, так и каждого текстового чанка. Это позволяет системе находить информацию, даже если она выражена другими словами, но имеет схожий смысл. Текстовый эмбеддинг — это числовое представление смысла, содержащегося в некотором тексте. Проще говоря, это способ преобразования слов, фраз и предложений в формат, с которым компьютеры могут работать математически. Представьте, что вы берете сложную человеческую речь и переводите ее в универсальный "язык" чисел, понятный машине. Процесс создания эмбеддинга выглядит следующим образом: Вы подаете текст (слово, предложение, абзац или целый документ) в специальную модель эмбеддингов. Модель обрабатывает текст и выдает длинный список чисел — это и есть эмбеддинг. Каждое число в этом списке обычно находится в определенном диапазоне (например, от -1 до +1, хотя это может варьироваться в зависимости от модели). Эти числа представляют различные качества или "признаки" входного текста. Таким образом, каждый текстовый фрагмент, будь то вопрос пользователя или чанк документа, превращается в уникальный числовой вектор. Чем ближе эти векторы друг к другу в многомерном пространстве, тем более схожим считается их семантическое значение.
План урока
- Введение в текстовые эмбеддинги: Основа семантического поиска
- Что такое текстовый эмбеддинг?
- Понимание числовых измерений эмбеддинга
- Почему эмбеддинги так важны для RAG и семантического поиска?
- Генерация текстовых эмбеддингов: Практический аспект
- Дальнейшие шаги: Сравнение эмбеддингов
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.