О чём урок
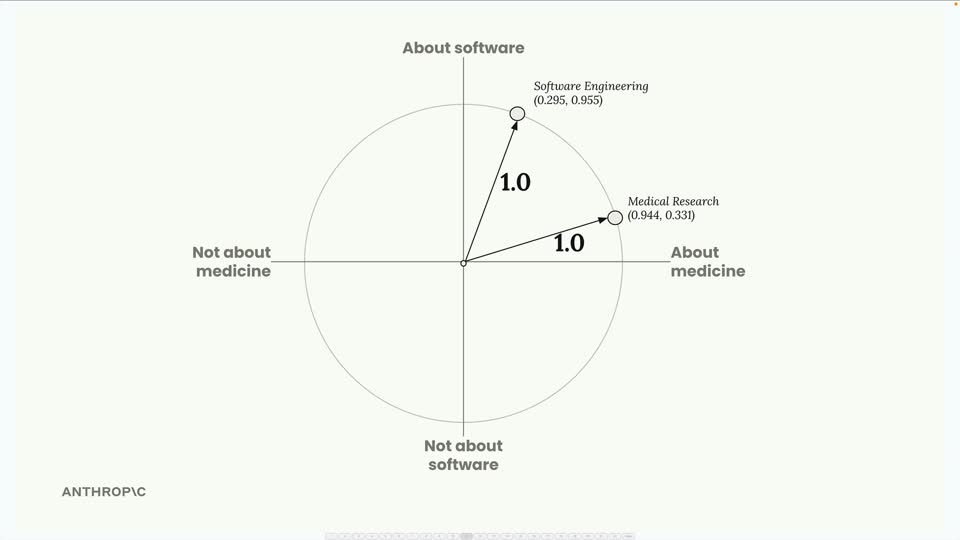
В мире больших языковых моделей (LLM), таких как Claude, способность генерировать связные и креативные ответы поражает. Однако их знания ограничены данными, на которых они были обучены. Что делать, если нам нужно, чтобы Claude отвечал на вопросы, используя самую свежую, специфическую или конфиденциальную информацию, которой нет в его тренировочных данных? Здесь на помощь приходит Retrieval Augmented Generation (RAG) — мощный подход, который позволяет LLM "заглядывать" во внешние источники знаний в реальном времени, значительно повышая точность и релевантность ответов. RAG — это не просто поиск информации; это интеллектуальный процесс, который извлекает наиболее релевантные данные и предоставляет их LLM в качестве контекста для генерации ответа. Давайте пошагово разберем, как работает полный цикл RAG, от подготовки ваших данных до получения ответа от Claude. Первый этап в любом RAG-процессе — это подготовка вашего исходного документа или набора документов. Большие тексты не могут быть полностью переданы LLM из-за ограничений на размер контекстного окна (количество токенов, которые модель может обработать за один раз). Поэтому мы разбиваем исходный текст на более мелкие, управляемые фрагменты (chunks). Представьте, что у нас есть два простых раздела из более крупного документа: Раздел 1: Медицинские исследования - "В этом году были достигнуты значительные успехи в нашем понимании XDR-47, 'бактерии', которую мы не видели раньше." Раздел 2: Разработка программного обеспечения - "Этот отдел приложил значительные усилия для изучения различных векторов заражения в наших распределенных системах." Каждый из этих фрагментов достаточно мал, чтобы быть обработанным индивидуально, но при этом содержит достаточно информации для сохранения смысла. После того как текст разбит на фрагменты, следующим шагом является преобразование каждого фрагмента в числовое представление, называемое эмбеддингом (embedding). Эмбеддинги — это многомерные векторы (списки чисел), которые улавливают семантическое значение текста. Тексты со схожим смыслом будут иметь эмбеддинги, расположенные близко друг к другу в многомерном пространстве.
План урока
- Полный цикл RAG: От запроса к точному ответу с Claude
- Шаг 1: Подготовка данных — Разделение текста на фрагменты (Chunking)
- Шаг 2: Создание эмбеддингов (Embeddings)
- Шаг 3: Хранение эмбеддингов в векторной базе данных (Vector Database)
- Шаг 4: Обработка пользовательского запроса
- Шаг 5: Поиск похожих эмбеддингов и релевантной информации
- Как работает сходство: Косинусное сходство (Cosine Similarity)
- Шаг 6: Формирование итогового промпта для Claude
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.