О чём урок
В предыдущих материалах мы познакомились с концепцией RAG (Retrieval Augmented Generation) и поняли, как она позволяет моделям Claude AI получать доступ к актуальной и специфической информации за пределами их первоначального обучения. Теперь пришло время перейти от теории к практике и рассмотреть пошаговую реализацию этого мощного подхода. Мы пройдем через полный пример, демонстрирующий, как разбить текст на фрагменты, сгенерировать для них embeddings, сохранить их в векторной базе данных и выполнить поиск по сходству.
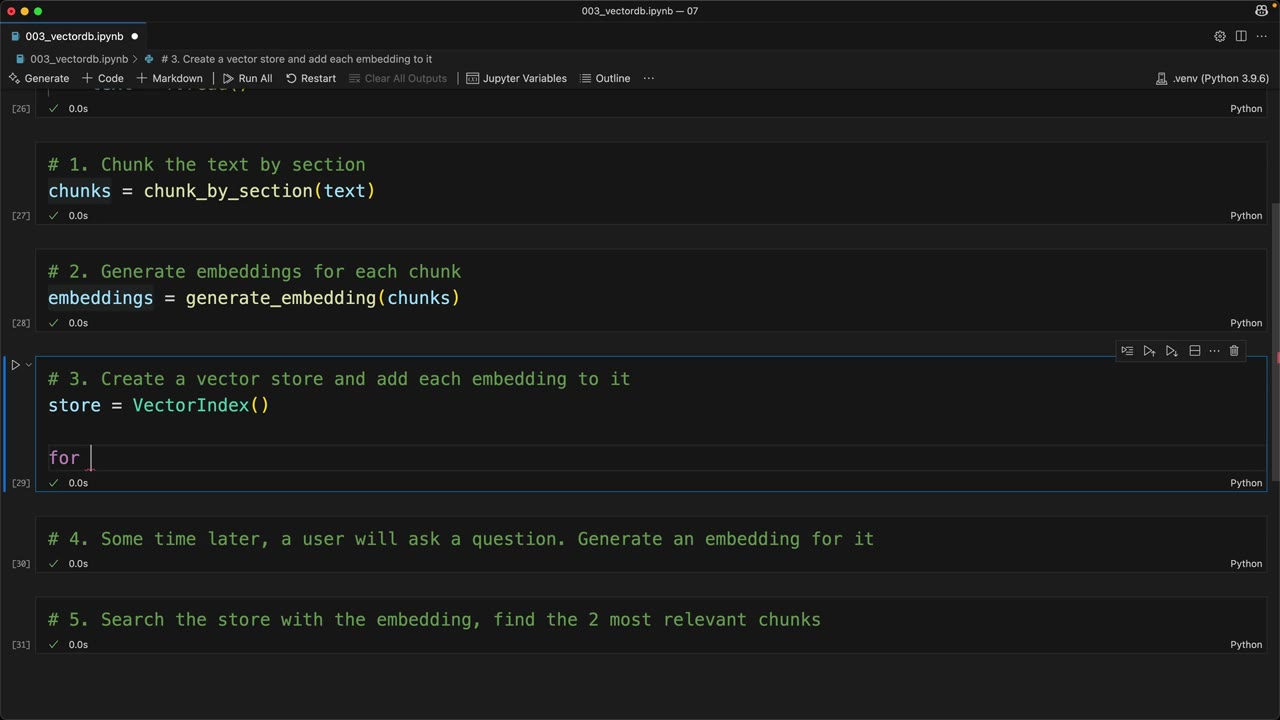
Наша реализация RAG следует тем же пяти ключевым шагам, которые мы обсуждали ранее. Эти шаги формируют основу для любой системы RAG, позволяя эффективно извлекать информацию и использовать ее для обогащения ответов LLM:
- Разделение текста на фрагменты (Chunking): Разбить исходный документ на управляемые части.
- Генерация эмбеддингов (Embeddings): Создать числовые представления (векторы) для каждого фрагмента текста.
- Создание векторного хранилища: Сохранить embeddings вместе с соответствующим текстом в специализированной базе данных.
- Обработка пользовательского запроса: Сгенерировать embedding для вопроса пользователя.
- Поиск релевантного контента: Найти наиболее похожие фрагменты в векторном хранилище.
Этот процесс позволяет нам эффективно преобразовывать запросы пользователей в числовые векторы и использовать их для поиска наиболее релевантного контента в нашей базе данных, обеспечивая точные и контекстуально обоснованные ответы от Claude.
Первый шаг в реализации RAG — это подготовка исходного документа. Большие документы, такие как отчеты, книги или статьи, слишком объемны для непосредственной обработки LLM или эффективного создания embeddings. Поэтому мы загружаем наш документ и разбиваем его на более мелкие, управляемые секции, или "фрагменты" (chunks).
Представьте, что у вас есть годовой отчет компании. Вместо того чтобы пытаться обработать весь отчет целиком, мы можем разделить его на логические секции: "Введение", "Отдел программной инженерии", "Отдел маркетинга", "Финансовые результаты" и так далее. Каждый такой раздел становится отдельным фрагментом. Это не только упрощает процесс создания embeddings, но и гарантирует, что каждый фрагмент содержит достаточно связную информацию, чтобы быть полезным при поиске.
После того как текст разделен на фрагменты…
План урока
- Реализация рабочего процесса RAG: Пошаговое руководство
- Пять шагов реализации RAG
- Шаг 1: Разделение текста на фрагменты (Chunking)
- Шаг 2: Генерация эмбеддингов (Embeddings)
- Шаг 3: Хранение в векторной базе данных (Vector Database)
- Почему важно хранить оригинальный текст?
- Шаг 4: Обработка пользовательских запросов
- Шаг 5: Поиск релевантного контента
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.