О чём урок
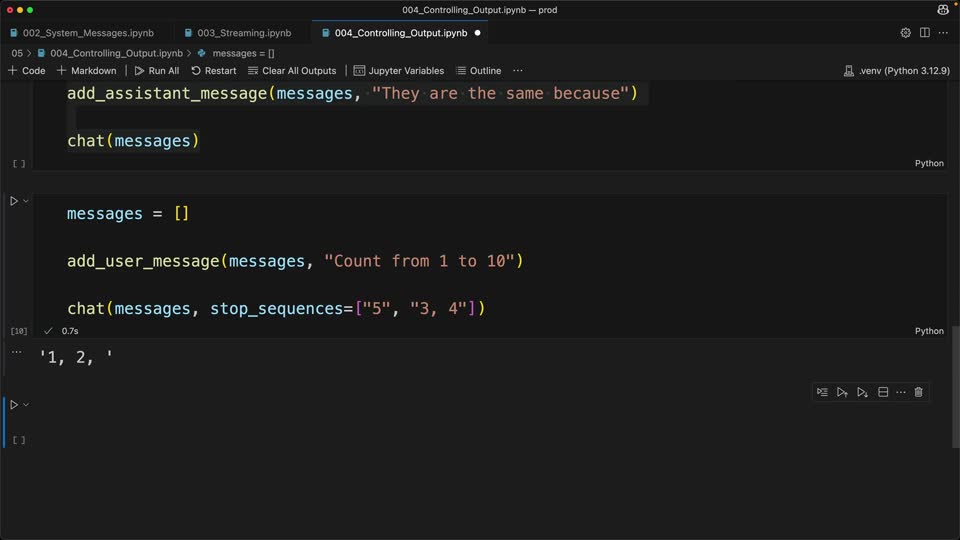
Работая с большими языковыми моделями (LLM), такими как Claude, мы часто стремимся получить от них не просто связный текст, а строго структурированные данные. Это может быть код на Python, объекты JSON, списки или конфигурационные файлы. Однако по умолчанию Claude, стремясь быть максимально полезным и информативным, часто добавляет к таким данным пояснительный текст, заголовки или форматирование Markdown. Это дополнительное "комментаторство" может стать серьезной проблемой, когда вам нужны только чистые данные для программного использования или прямого копирования. Представьте, что вы разрабатываете веб-приложение, которое генерирует правила для AWS EventBridge. Пользователь вводит описание желаемого правила, нажимает "сгенерировать" и ожидает получить чистый JSON, который можно немедленно скопировать и использовать. Если Claude возвращает JSON, обернутый в блоки кода Markdown с пояснительным текстом, пользователь не сможет просто скопировать весь ответ. Ему придется вручную выделять только ту часть, которая является JSON-объектом, что ухудшает пользовательский опыт. По умолчанию Claude имеет тенденцию форматировать структурированный вывод примерно так: Хотя такой формат отлично подходит для документации или интерактивного общения, он становится проблематичным, когда вам нужен только JSON для программного использования. Извлечение чистого JSON из такого ответа требует дополнительной обработки, что усложняет логику вашего приложения и снижает его эффективность. К счастью, существует элегантное решение, позволяющее получить от Claude именно тот контент, который вам нужен, без лишних оберток. Оно заключается в комбинировании двух мощных техник: предзаполнения сообщения ассистента (Assistant Message Prefilling) и использования стоп-последовательностей (Stop Sequences). Давайте рассмотрим, как это работает на примере генерации JSON: Эта техника работает следующим образом: Предзаполнение сообщения ассистента: Вы начинаете диалог, добавляя в историю сообщений уже "начатое" сообщение от ассистента. В нашем случае это открывающий ограничитель Markdown для блока кода: "```json". Это как бы говорит Claude: "Я уже начал писать блок JSON, продолжай с этого места." Установка стоп-последовательности: Вы указываете API, что генерация должна быть немедленно остановлена, как только Claude попытается сгенерировать определенную последовательность символов.
План урока
- Получение структурированных данных от Claude: Избегаем лишнего
- Проблема стандартного поведения Claude
- Решение: Предзаполнение сообщения ассистента и стоп-последовательности
- Как это работает "под капотом"
- Применение и очистка результатов
Урок входит в полный доступ. Полный текст и видео открываются после оплаты. Первые уроки каждого курса бесплатны.